데이터를 빠르게, 안전하게, 그리고 효율적으로 전달하는 것. 디지털 시대 내내 네트워크가 지켜 온 원칙입니다. AI 시대에도 이 원칙은 그대로입니다. 다만 수천 개의 GPU(Graphics Processing Unit)가 하나의 작업을 함께 수행하는 AI 인프라에서는 '빠르다', '안전하다', '효율적이다'를 판단하는 기준이 이전과 달라졌습니다. 이 글에서는 웹 서비스 데이터센터와 비교해 AI 학습과 추론 환경에서 데이터의 흐름이 어떻게 달라졌는지 살펴보고, 세 가지 관점에서 GPU들의 공장인 AI 팩토리(AI Factory)를 구축하고 운영할 때 네트워크가 갖춰야 할 설계 원칙과 기업의 준비 방향을 정리합니다.
- 네트워크의 원칙은 그대로이고, 기준이 달라졌습니다.
웹 서비스 중심의 데이터센터에서 '빠르다'는 사용자의 요청에 서버가 지체 없이 응답한다는 뜻이었습니다. '안전하다'는 외부 위협으로부터 시스템을 보호하고 장애가 생겨도 서비스를 이어간다는 의미였고, '효율적이다'는 한정된 회선과 장비를 여러 서비스가 알맞게 나눠 쓴다는 의미였습니다.
AI 인프라에서도 이 세 가지는 여전히 네트워크 설계의 출발점입니다. 달라진 것은 네트워크가 연결하는 대상입니다. 대규모 AI 모델은 GPU 한 장의 메모리에 담기지 않기 때문에, 수백에서 수천 개의 GPU가 모델을 나눠 맡고 계산 결과를 계속 주고받으며 하나의 작업을 완성합니다. 네트워크가 사람과 서버를 잇는 데서 나아가, 여러 GPU를 하나의 거대한 컴퓨터처럼 묶는 역할까지 맡게 된 것입니다.
역할이 넓어지면서 세 가지 원칙의 기준도 한층 높아졌습니다. '빠르게'는 평균 속도보다 모든 GPU가 함께 작업을 마치는 시간을 중시하게 됐고, '안전하게'는 데이터를 하나도 잃지 않고 서로 다른 작업이 간섭하지 않는 것까지 포함하게 됐습니다. '효율적으로'는 고가의 GPU 자원이 쉬지 않고 일하도록 만드는 것을 뜻하게 됐습니다.
AI 인프라에서 달라진 데이터의 흐름
– 트래픽의 방향과 형태가 달라졌습니다.
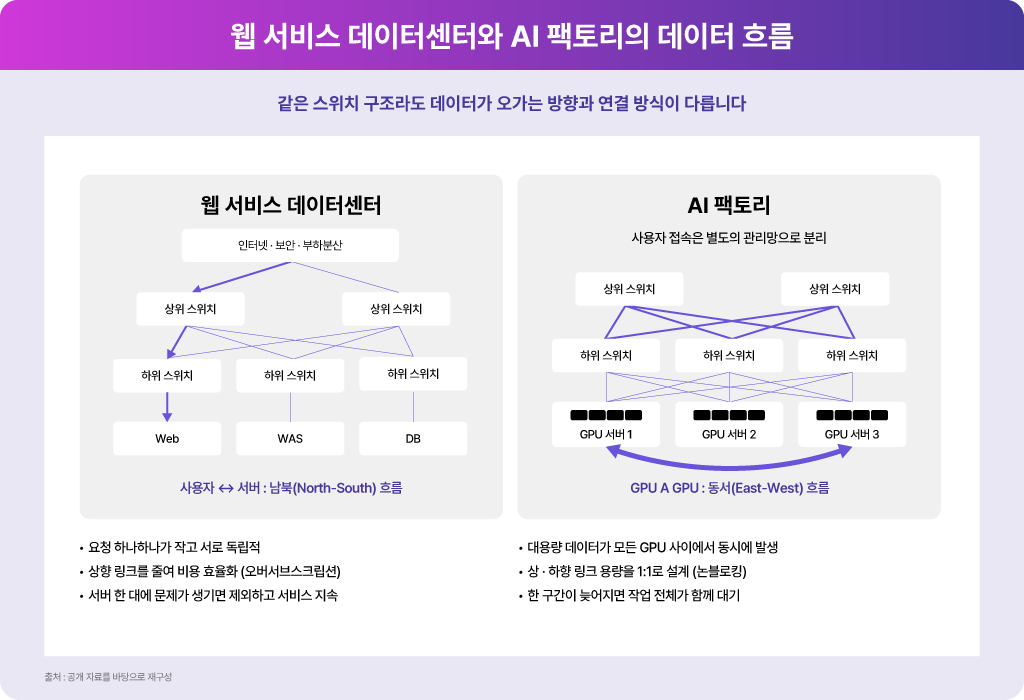
웹 서비스 데이터센터에서는 사용자와 서버 사이를 오가는 남북(North-South) 방향의 트래픽이 중심입니다. 사용자의 요청은 보안 장비와 부하분산 장비를 거쳐 웹 서버, 애플리케이션 서버, 데이터베이스로 전달됩니다. 요청 하나 하나는 작고 서로 독립적이어서, 서버 한 대에 이상이 생기면 부하분산 장비가 해당 서버를 제외하고 서비스를 이어 갑니다. 모든 서버가 동시에 최대 속도로 통신하는 경우는 드물기 때문에, 스위치의 상향 링크를 하향 링크보다 적게 두는 오버서브스크립션(Oversubscription) 설계가 일반적으로 쓰였습니다.
AI 팩토리에서는 데이터센터 내부의 GPU와 GPU 사이를 오가는 동서(East-West) 방향 트래픽이 중심이 됩니다. 모든 GPU가 같은 순간에 최대 속도로 데이터를 주고받는 것이 평상시의 모습이고, 한 GPU의 작업이 늦어지면 다른 GPU들도 그만큼 기다려야 합니다. 그래서 GPU 간 네트워크는 상향과 하향 링크의 용량을 같게 맞춘 논블로킹(Non-blocking) 구조로 설계합니다.
– 학습은 모든 GPU가 보조를 맞추는 작업입니다.
대규모 모델 학습은 계산, 결과 교환, 동기화가 수만 번 반복되는 과정입니다. 각 GPU는 맡은 부분의 계산을 마친 뒤 그 결과를 다른 GPU들과 주고받아 합산합니다. 이를 집합 통신(Collective Communication)이라 하며, 대표적인 방식이 올리듀스(All-Reduce)입니다. 이 교환이 모두 끝나야 다음 계산이 시작됩니다.
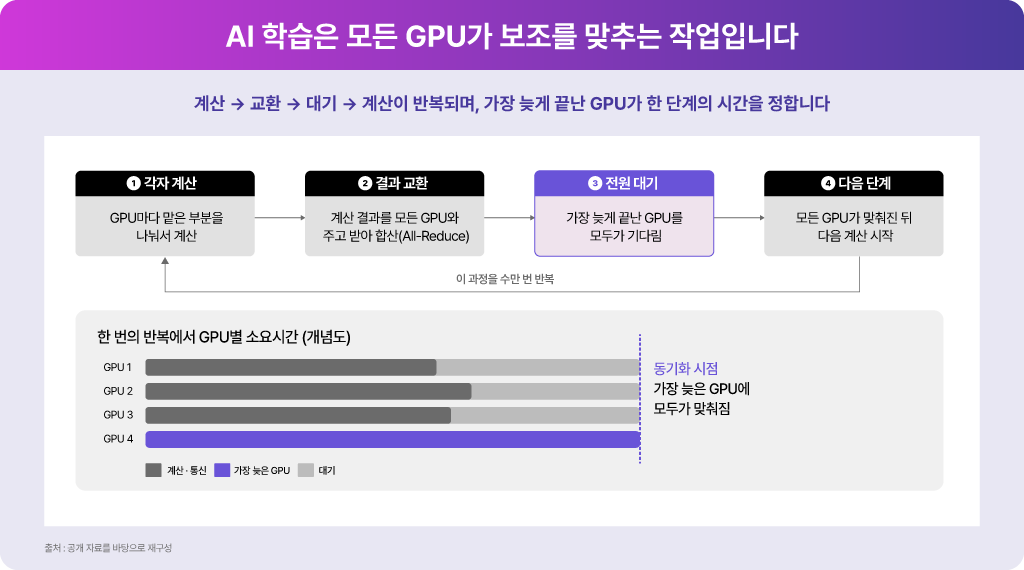
이 구조에서는 가장 늦게 끝난 GPU가 한 단계의 시간을 결정합니다. 999대의 GPU가 1밀리초 만에 교환을 마쳐도 한 대가 100밀리초가 걸리면 그 단계는 100밀리초가 됩니다. AI 네트워크에서 평균 지연보다 가장 늦은 구간의 지연, 즉 꼬리 지연(Tail Latency)을 중요하게 보는 이유입니다.
트래픽의 형태도 다릅니다. 일반 데이터센터에는 작은 흐름이 수없이 섞여 있지만, AI 학습에서는 수 기가바이트 규모의 큰 흐름 몇 개가 전체 트래픽의 대부분을 차지합니다. 이를 엘리펀트 플로우(Elephant Flow)라고 합니다. 또 동기화 시점에는 여러 GPU가 한 GPU를 향해 동시에 데이터를 보내는 인캐스트(Incast)가 자주 발생합니다. 크고, 동시에 발생하고, 한곳으로 모이는 흐름을 안정적으로 처리하는 것이 AI 네트워크 설계의 출발점입니다.
– 추론은 예측하기 어려운 요청에 바로 응답하는 작업입니다.
학습이 하나의 큰 작업을 며칠에서 몇 주에 걸쳐 일정한 패턴으로 수행한다면, 추론은 수많은 사용자의 짧은 요청을 동시에 처리합니다. 요청이 언제 몰릴지 예측하기 어렵고, 사용자는 첫 답변이 나오기까지의 시간(TTFT, Time To First Token)으로 품질을 체감합니다.
최근에는 질문을 읽고 이해하는 과정과 답변을 만들어 내는 과정을 서로 다른 GPU에 맡기는 분리형 추론(Disaggregated Serving)이 확산되고 있습니다. 이 방식에서는 질문을 이해한 GPU가 만든 중간 결과를 답변을 생성하는 GPU로 넘겨야 하며, 추론 소프트웨어들은 이 전송 효율을 분리형 추론 성능의 주요 요소로 꼽습니다. 추론에서도 GPU 간 네트워크의 역할이 커지고 있는 것입니다.
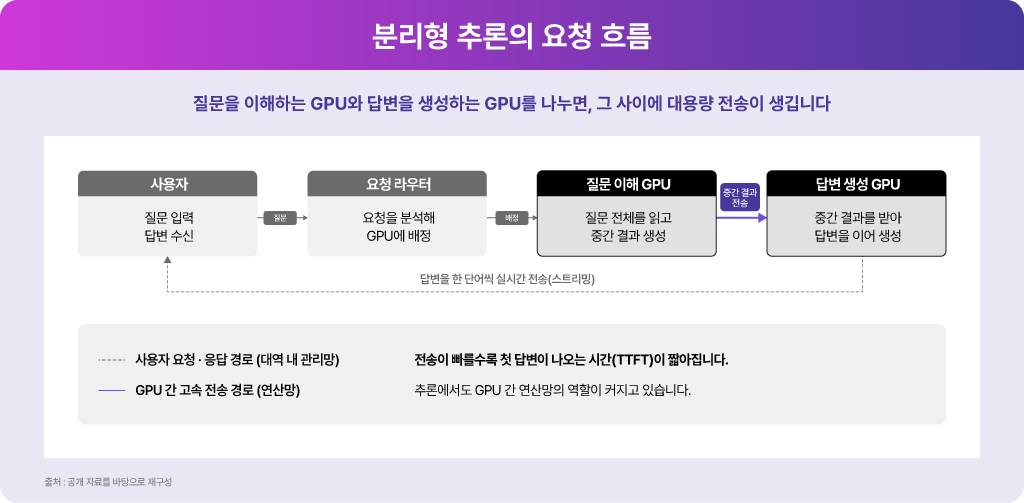
AI 에이전트가 확산되면 이런 경향은 더 뚜렷해집니다. 에이전트는 사용자의 요청 한 번에 스스로 계획을 세우고, 필요한 도구를 호출하고, 결과를 검토하는 과정을 거치며 내부적으로 여러 차례 추론을 수행하기 때문입니다.
빠르게 : 평균 속도에서 '함께 끝나는 시간'으로
– 가장 늦게 도착하는 데이터가 기준이 됩니다.
AI 인프라에서 '빠른 네트워크'는 단순히 회선 속도가 높은 네트워크가 아닙니다. 모든 GPU가 주고받는 데이터가 고르게, 그리고 예측 가능한 시간 안에 도착하는 네트워크입니다. 분산 학습의 통신을 분석한 연구에 따르면, 대규모 운영 환경에서 GPU 간 통신이 학습 1회 반복 시간의 최대 60%를 차지한 사례가 있습니다. GPU의 연산 성능이 높아질수록 전체 학습 시간에서 통신이 차지하는 비중은 더 커지므로, 네트워크 설계가 학습 시간을 좌우하는 요소가 되고 있습니다.
그래서 AI 네트워크의 성능은 작업 완료 시간(JCT, Job Completion Time)과 꼬리 지연으로 평가합니다. 평균적으로 빠른 것보다 가장 늦은 데이터까지 일정하게 빨리 도착하는 것이 중요합니다.
– 거리에 따라 연결 방식을 달리합니다.
AI 팩토리의 네트워크는 데이터가 오가는 거리에 따라 세 개의 층으로 구성됩니다. 거리가 가까울수록 더 넓은 대역폭과 더 짧은 지연을 확보할 수 있기 때문에, 층마다 연결 방식과 설계 목표가 다릅니다.
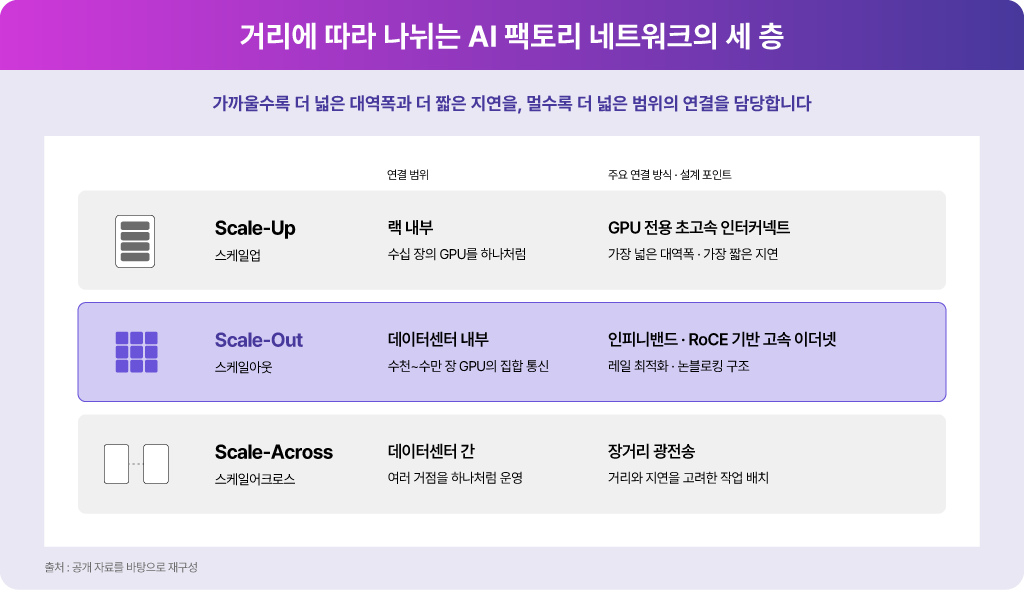
스케일업(Scale-Up)은 랙 안의 GPU를 하나의 큰 GPU처럼 묶는 영역입니다. 일반 네트워크 대신 GPU 전용 초고속 인터커넥트로 수십 장의 GPU를 연결합니다. 스케일아웃(Scale-Out)은 서버와 서버를 잇는 영역으로, 수천에서 수만 개의 GPU가 집합 통신을 수행합니다. 이 영역에는 인피니밴드(InfiniBand)나, RDMA를 이더넷에서 구현한 RoCE(RDMA over Converged Ethernet) 기반의 고속 이더넷이 주로 쓰입니다. 스케일어크로스(Scale-Across)는 데이터센터와 데이터센터를 잇는 영역입니다. 한 부지에 공급할 수 있는 전력에 한계가 있어, 여러 데이터센터를 장거리 광전송으로 연결해 하나처럼 운영하는 사례가 늘고 있습니다.
– 같은 번호의 GPU끼리 묶어 경로를 줄입니다.
스케일아웃 영역은 흔히 레일 최적화(Rail-Optimized) 구조로 설계합니다. 모든 서버의 1번 GPU는 1번 스위치에, 2번 GPU는 2번 스위치에 연결하는 방식입니다. 서로 다른 서버에 있는 같은 번호의 GPU가 스위치 하나만 거쳐 만나므로, 학습 중 가장 빈번한 데이터 교환이 짧은 경로에서 처리됩니다. 주요 GPU 제조사의 공개 레퍼런스 아키텍처도 이 구조를 기본으로 제시하고 있습니다.
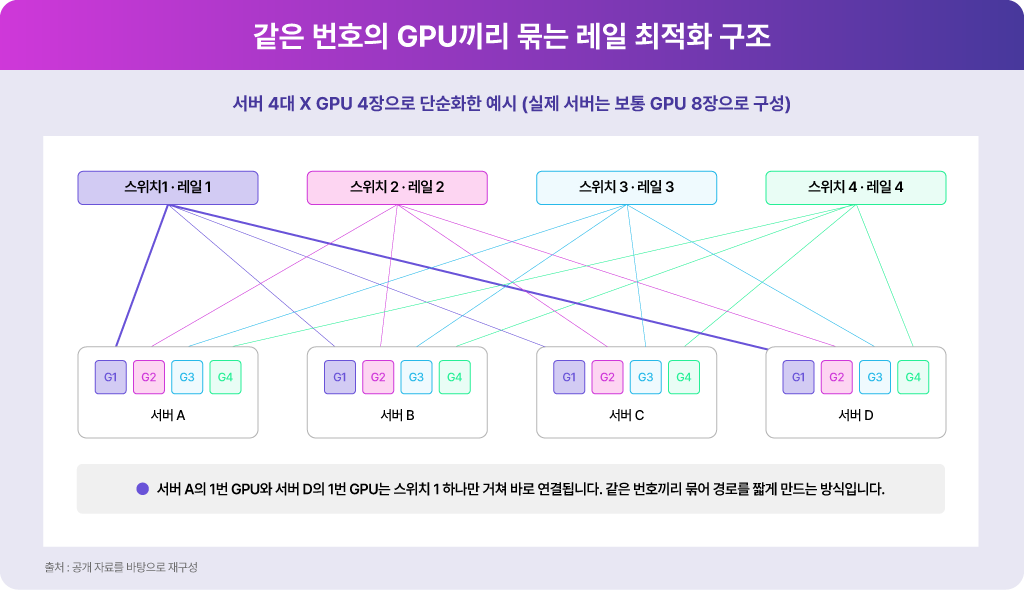
여기에 앞서 설명한 논블로킹 구조를 더하면, 모든 GPU가 동시에 최대 속도로 통신해도 대역폭이 모자라지 않습니다. 같은 스위치 구조라도 웹 서비스 데이터센터가 대역폭을 나눠 쓰는 방식이라면, AI 팩토리는 필요한 대역폭을 처음부터 온전히 확보하는 방식입니다.
안전하게 : 데이터를 잃지 않고, 서로 간섭하지 않도록
– 데이터를 하나도 잃지 않는 무손실 전송을 설계합니다.
웹 서비스에서는 패킷이 일부 유실되더라도 TCP가 다시 전송해 큰 영향 없이 복구됩니다. 반면 GPU 간 통신에 쓰이는 RDMA(Remote Direct Memory Access)는 손실에 민감해서, 패킷 하나를 다시 보내는 동안 여러 GPU가 함께 기다리게 됩니다. 그래서 AI 네트워크에서 '안전하다'는 데이터를 잃지 않고 전달하는 무손실(Lossless) 전송을 의미합니다.
무손실 전송은 두 가지 방법으로 구현합니다. 스위치는 대기열이 차오르기 시작하면 패킷에 혼잡 표시(ECN, Explicit Congestion Notification)를 남기고, 이를 전달받은 송신 측 네트워크 카드가 전송 속도를 낮춥니다. 그래도 버퍼가 넘칠 상황이 되면 우선순위 기반 흐름 제어(PFC, Priority Flow Control)가 앞단 장비에 잠시 멈추라는 신호를 보내 패킷이 버려지지 않게 합니다.
이때 중요한 것은 일관성입니다. 이 설정은 스위치, 네트워크 카드, 서버 운영체제 전체에 같은 기준으로 적용돼야 합니다. 우선순위 매핑이나 버퍼 임계치가 한 곳에서만 달라도 일시 정지 신호가 연쇄적으로 퍼져 관련 없는 트래픽까지 멈출 수 있습니다. 무손실 네트워크는 기능을 켜는 것으로 완성되지 않으며, 종단 간(End-to-End) 정책을 하나의 기준으로 설계하고 검증해야 합니다.
– 역할에 따라 네트워크를 나눕니다.
AI 팩토리에는 성격이 다른 데이터가 함께 흐릅니다. GPU 사이의 학습 데이터, 스토리지에서 읽어 오는 원본 데이터, 사용자의 요청, 장비를 제어하는 관리 신호가 한 네트워크에 섞이면 서로의 성능에 영향을 줍니다. 그래서 업계의 표준적인 설계는 네트워크를 대개 네 가지로 나눕니다.
첫째는 GPU 간 집합 통신을 담당하는 연산망(Compute Fabric)입니다. 둘째는 학습 데이터를 읽고 학습 상태를 저장하는 스토리지망(Storage Fabric)입니다. 셋째는 사용자 접속과 작업 배포, 클러스터 운영에 쓰는 대역 내(In-band) 관리망이고, 넷째는 장비의 전원과 콘솔을 원격으로 제어하는 대역 외(Out-of-Band) 관리망입니다. GPU 8장이 탑재되는 일반적인 AI 서버에는 연산망 전용 네트워크 카드가 GPU 수만큼 장착되고, 스토리지·대역 내 관리망용 카드와 원격 관리 포트가 따로 구성됩니다.
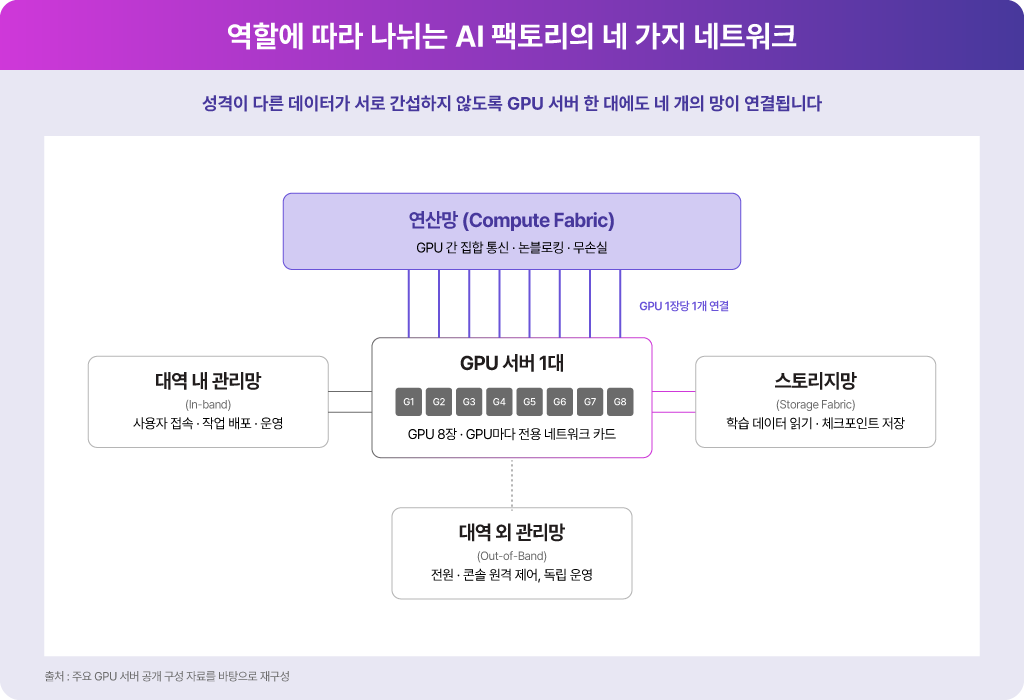
망을 나누는 이유는 데이터 흐름의 차이에 있습니다. 대규모 학습은 장애에 대비해 학습 상태를 주기적으로 저장(체크포인트)하는데, 수천 개의 GPU가 거의 동시에 저장을 시작하면 스토리지 트래픽이 순간적으로 크게 늘어납니다. 스토리지망을 연산망과 분리하면 이런 순간에도 GPU 간 통신이 영향을 받지 않습니다. 대역 외 관리망은 대역폭은 작지만 다른 네트워크에 장애가 생겨도 장비에 접근할 수 있어야 하므로 물리적으로 독립시킵니다.
– 함께 쓰는 환경일수록 성능까지 분리합니다.
AI 팩토리는 여러 부서나 고객사가 함께 사용하는 멀티테넌트(Multi-Tenant) 형태로 운영되는 경우가 많습니다. 이때는 가상 라우팅 분리(VRF, Virtual Routing and Forwarding)나 네트워크 파티션으로 테넌트 간 통신을 차단하되, 공유 스토리지처럼 함께 쓰는 자원에는 모든 테넌트가 접근할 수 있도록 설계합니다. 웹 서비스 환경의 분리가 접근 권한 중심이었다면, AI 팩토리에서는 한 테넌트의 대규모 학습이 다른 테넌트의 추론 응답을 늦추지 않도록 성능까지 분리하는 것이 중요합니다.
효율적으로 : GPU 자원이 쉬지 않고 일하도록
– 경로를 분산하고, 전송 속도를 조절합니다.
AI 인프라에서 '효율적인 네트워크'는 가장 비싼 자원인 GPU가 데이터를 기다리는 시간을 최소화하는 네트워크입니다. 이를 위해서는 먼저 여러 경로를 고르게 써야 합니다. 기존 네트워크는 ECMP(Equal-Cost Multi-Path) 방식으로 흐름마다 경로를 정해 분산합니다. 흐름이 수백만 개일 때는 트래픽이 고르게 퍼지지만, 엘리펀트 플로우처럼 흐름의 수가 적고 크기가 크면 일부 경로에 쏠릴 수 있습니다.
AI 네트워크는 스위치가 링크 상태를 실시간으로 판단해 여유 있는 경로로 데이터를 보내는 적응형 라우팅(Adaptive Routing)이나, 하나의 흐름을 여러 경로에 패킷 단위로 나눠 보내는 패킷 분산(Packet Spraying)을 활용합니다. 한 글로벌 네트워크 장비 기업이 공개한 AI 클러스터 검증 결과에서는 흐름 단위 분산 대신 패킷 단위 분산을 적용했을 때 GPU 간 전체 교환(All-to-All) 성능이 37.5% 향상됐습니다. 다만 패킷이 여러 경로로 나뉘면 도착 순서가 바뀔 수 있으므로, 수신 측 네트워크 카드가 순서를 다시 맞출 수 있는지도 함께 확인해야 합니다.
여러 GPU가 같은 목적지로 데이터를 보내는 인캐스트는 경로를 바꾸는 것만으로는 해소되지 않습니다. 이때는 앞서 설명한 혼잡 표시를 바탕으로 송신 측이 전송 속도를 조절합니다. 경로 분산과 송신 속도 조절이 함께 동작해야 네트워크 전체를 고르게 활용할 수 있습니다.
– 밀리초 단위의 관측 체계가 필요합니다.
AI 트래픽의 혼잡은 몇 밀리초 동안 나타났다 사라지는 마이크로버스트(Microburst) 형태가 많습니다. 5분 간격의 SNMP 수집처럼 수 분 단위로 평균을 내는 방식에서는 링크 사용률이 낮게 보이지만, 그 짧은 순간에 버퍼가 차고 GPU가 대기할 수 있습니다.
그래서 AI 팩토리에는 스위치 칩(ASIC) 수준에서 밀리초 단위로 상태를 수집하는 스트리밍 텔레메트리(Streaming Telemetry)와, 패킷이 버려졌을 때 원인까지 기록하는 분석 기능이 필요합니다. 운영 지표도 평균 사용률보다 작업 완료 시간, 집합 통신 대역폭, 꼬리 지연, 혼잡 표시와 일시 정지 신호의 발생 빈도, 추론의 첫 응답 시간을 중심으로 관리하는 것이 바람직합니다.
– 전력과 냉각까지 함께 고려합니다.
효율은 성능에만 해당하지 않습니다. GPU 서버마다 고속 네트워크 카드와 광 모듈이 여러 개 연결되면서, 네트워크 장비가 소비하는 전력과 발생하는 열도 함께 늘었습니다. 랙당 전력 밀도가 높은 AI 데이터센터에서는 네트워크 구성과 광 모듈 수량을 전력·냉각 설계와 함께 검토해야 전체 효율을 높일 수 있습니다.
AI 인프라 도입을 준비하는 기업을 위한 제언
– 네트워크는 GPU와 함께 설계하고, 단계적으로 확장합니다.
수십에서 수백 장 규모의 GPU로 자체 AI 인프라를 검토하는 기업이라면, 설계의 출발점은 네트워크를 GPU와 함께 확정하는 것입니다. GPU 서버를 먼저 정하고 네트워크를 나중에 맞추면 토폴로지와 포트 수, 광 모듈 수량을 다시 산정해야 하기 때문입니다. 이와 함께 연산망·스토리지망·관리망 등 네트워크의 역할 구분, 공급사가 다른 장비 사이의 무손실 설정 검증 책임, 전력·냉각과의 통합 검토, 그리고 학습뿐 아니라 추론과 에이전트까지 반영한 용량 산정을 설계 초기에 함께 정리해 두는 것이 좋습니다. 구축 단계에서는 집합 통신 벤치마크와 장애 시나리오로 혼잡 제어와 무손실 동작을 종단 간 검증한 뒤 서비스를 시작합니다. AI 네트워크 기술은 빠르게 발전하고 있으므로, 도입 시점의 기술 동향과 함께 앞서 살펴본 원칙을 충족하는지를 기준으로 검토하면 장기적으로 유연하게 대응할 수 있습니다.
– 운영 단계의 관리 체계가 성능을 유지합니다.
대규모 GPU 팜의 네트워크 운영에서 먼저 갖춰야 할 것은 플랫폼 기반의 관리 체계입니다. 수천 개의 포트와 광 모듈, 장비마다 흩어져 있는 무손실 설정을 장비 하나하나 개별 솔루션으로 다루는 방식으로는 대규모 환경에서 일관성을 유지하기 어렵습니다. 네트워크 전체를 하나의 패브릭(Fabric)으로 보고 설정의 배포와 검증, 상태 관측, 변경 적용을 통합 관리 플랫폼에서 일괄 수행해야, 규모가 커져도 사람의 실수를 줄이고 같은 품질을 유지할 수 있습니다. 이어서 살펴볼 기준선 관리와 관측, 변경·장애 대응도 이 플랫폼 위에서 자동화할수록 효과가 커집니다.
성능 관리의 기준은 성능 기준선(Baseline)입니다. 구축 직후 측정한 집합 통신 벤치마크와 작업 완료 시간을 기준선으로 보존하고 정기적으로 재측정해 비교하면, 광 모듈 열화나 케이블 불량처럼 서서히 진행되는 성능 저하를 조기에 찾아낼 수 있습니다. 일상 관측은 평균 사용률 중심의 경보에서 벗어나 작업 완료 시간과 꼬리 지연, 혼잡 표시와 일시 정지 신호의 발생 빈도, 추론의 첫 응답 시간을 중심 지표로 삼고, 밀리초 단위 텔레메트리로 짧은 순간의 혼잡까지 들여다봐야 합니다.
변경 관리와 장애 대응의 기준도 한층 높아졌습니다. 스위치 운영체제, 네트워크 카드 펌웨어, 집합 통신 라이브러리는 서로 맞물려 동작하므로 한 구간의 버전만 바꿔도 전체 성능이 달라질 수 있습니다. 변경 전에 검증을 거쳐 단계적으로 적용하는 절차가 필요합니다. 또한 링크 하나의 품질 저하가 수천 개 GPU의 작업 완료 시간에 영향을 주므로, 오류 카운터나 광 신호 세기 같은 사전 징후를 상시 감시하고 예비 광 모듈과 케이블을 확보해 신속히 격리하고 교체하는 체계를 갖춰야 합니다.
운영 역량도 기술과 함께 준비할 부분입니다. AI 네트워크에서 발생하는 문제는 네트워크 지표만으로는 원인을 찾기 어렵고, GPU에서 수행되는 작업의 동작과 함께 볼 때 해석되는 경우가 많습니다. 네트워크 영역과 AI 플랫폼 영역이 같은 지표를 공유하고 함께 분석하는 환경을 갖출수록 문제를 빠르게 해결하고 운영 품질을 높일 수 있습니다.
– 원칙은 같고, 준비의 깊이가 달라졌습니다.
AI 시대에도 네트워크의 역할은 데이터를 빠르게, 안전하게, 효율적으로 전달하는 것입니다. 달라진 것은 그 대상이 수천 개의 GPU로 넓어졌고, 각 원칙에 요구되는 수준이 높아졌다는 점입니다.
AI 인프라는 GPU 확보에서 시작하지만, 그 가치를 온전히 끌어내는 것은 GPU를 하나로 묶는 네트워크입니다. 트래픽의 특성을 이해한 설계, 역할과 거리에 따른 구조화, 짧은 순간까지 들여다보는 운영 체계를 함께 준비할 때 AI 인프라 투자가 기대한 성과로 이어질 수 있습니다.
▌요약
- 네트워크의 기본 원칙인 '빠르게, 안전하게, 효율적으로'는 AI 시대에도 변함이 없지만, 수천 개의 GPU를 하나로 묶는 AI 인프라에서는 각 원칙의 기준이 한층 높아졌습니다.
- AI 트래픽은 GPU 사이에서 크고, 동시에, 한곳으로 모이는 형태로 발생합니다. 학습은 가장 늦게 끝난 GPU가 전체 속도를 정하고, 추론은 예측하기 어려운 요청과 GPU 간 중간 결과 전송에 대응해야 합니다.
- '빠르게'를 위해서는 꼬리 지연과 작업 완료 시간을 기준으로 스케일업·스케일아웃·스케일어크로스 구조와 레일 최적화, 논블로킹 설계를 갖춰야 합니다. '안전하게'를 위해서는 종단 간 일관된 무손실 전송, 역할별 네트워크 분리, 테넌트 간 성능 분리가 필요합니다.
- '효율적으로'를 위해서는 실시간 경로 분산과 송신 속도 조절, 밀리초 단위 관측, 전력·냉각을 고려한 설계로 GPU 자원이 쉬지 않고 일하도록 해야 합니다. 기업은 네트워크를 GPU와 함께 설계하고, 구축 후에는 플랫폼 기반의 통합 관리 체계 위에서 성능 기준선과 변경·장애 관리를 갖춰 운영 단계에서 성능을 유지해 나가는 것이 바람직합니다.
▌ FAQ
Q1. 기존 데이터센터 네트워크를 AI 인프라에 그대로 활용할 수 있나요?
A1. 대역 내 관리망과 일부 스토리지망은 기존 인프라를 활용할 수 있습니다. 다만 GPU 간 연산망은 논블로킹과 무손실 전송이 필요해 별도로 설계하는 것이 일반적입니다. 기존 네트워크를 어디까지 활용할지는 워크로드와 트래픽을 측정한 뒤 정하는 것이 좋습니다.
Q2. GPU 수십 장 규모로 시작해도 전용 네트워크가 필요한가요?
A2. 서버 한 대 안에서 학습과 추론이 끝난다면 네트워크 부담이 크지 않습니다. 그러나 여러 서버에 걸쳐 분산 학습이나 분리형 추론을 수행한다면 전용 연산망이 필요합니다. 처음 규모가 작더라도 향후 확장을 고려해 토폴로지와 주소 체계를 미리 설계해 두는 것이 좋습니다.
Q3. 인피니밴드와 이더넷 중 어떤 방식을 선택해야 하나요?
A3. 두 방식 모두 AI 연산망에 쓰이고 있으며, 최근에는 AI 워크로드에 맞게 개선된 이더넷과 개방형 표준이 확산되면서 선택의 폭이 넓어졌습니다. 기존 운영 역량, 클러스터 규모, 확장 계획, 장비 조달 여건을 함께 고려해 판단하는 것이 바람직합니다.
Q4. 추론 위주로 사용하더라도 네트워크 투자가 필요한가요?
A4. 추론은 학습만큼 큰 대역폭을 요구하지는 않지만, 분리형 추론과 AI 에이전트가 확산되면서 GPU 간 데이터 전송과 순간적인 요청 집중이 늘고 있습니다. 응답 시간이 곧 서비스 품질로 이어지므로, 추론을 기준으로 용량을 산정하고 관측 체계를 갖추는 것이 좋습니다.
Q5. AI 네트워크의 성능은 어떻게 측정하고 평가하나요?
A5. 평균 사용률보다 작업 완료 시간, 집합 통신 대역폭, 꼬리 지연, 혼잡 표시와 일시 정지 신호의 발생 빈도, 추론의 첫 응답 시간을 함께 측정합니다. 밀리초 단위 관측과 패킷 손실 원인 분석이 가능해야 개선이 필요한 구간을 정확히 찾을 수 있습니다.
▌ 참고자료
1. arXiv, “Communication Optimization for Distributed Training: Architecture, Advances, and Opportunities,” 2024.
2. NVIDIA, “DGX SuperPOD Reference Architecture,” 온라인 문서.
3. NVIDIA, “NVIDIA DGX B200 User Guide,” 2025.
4. NVIDIA, “Dynamo: Disaggregated Serving,” 온라인 문서.
5. Cisco, “Cisco Nexus 9000 Series Switches for AI Clusters White Paper,” 온라인 문서.
6. Ultra Ethernet Consortium, “UEC Launches Specification 1.0,” 2025.
※ 본문 이미지는 공개 자료를 바탕으로 구조를 단순화해 재구성한 개념도이며, 실제 구성은 제품과 규모에 따라 달라질 수 있습니다. 본문의 수치는 각 출처의 공개 자료를 기준으로 합니다.
관련 오퍼링 및 문의하기
본 콘텐츠는 저작권법에 의해 보호받는 저작물로 LG CNS에 저작권이 있습니다.
사전 동의 없이 2차 가공 및 영리적인 이용을 금합니다.