HPC (High-Performance Computing)가 기존의 정밀한 시뮬레이션 및 정확한 연산을 목표로 하고 있다면, 대규모 AI를 위한 Infra는 높은 정밀도보다는 대규모 Data를 기반으로 한 병렬 반복 연산이 주된 목적이라는 점에서 구분됩니다. Infra에 있어서도 HPC가 CPU 중심이라면 AI Infra는 GPU 중심으로 운영되어 왔습니다. 하지만 복잡도가 높아지고 초거대 모델 학습에 점점 더 많은 Computing Power가 필요해지면서, 최근에는 둘 사이의 경계가 모호해지고 HPC의 대규모 연산 인프라와 관리 기술을 AI에 활용하는 사례가 늘고 있습니다. 시뮬레이션을 위한 슈퍼컴퓨팅이던 HPC의 기술들은 이제 AI 학습·추론을 함께 떠받치는 중요한 인프라가 되었습니다. GPU 노드를 빨리 늘리는 것만으로는 성공하기 어렵습니다. Global한 고객 환경, On-Premise기반의 대규모 CPU/GPU 클러스터, 다양한 Cloud 가 존재하는 환경에서 이들을 하나의 Control Plane으로 묶을지, 사용자와 권한을 어떻게 관리하는지, 보안 Baseline을 어떻게 지키는지, 반복 구축을 어떻게 자동화하는지 등을 중요한 고려사항으로 두어야 합니다. 이 글에서는 최신 트렌드와 HPC·AI Workload의 차이를 먼저 살펴보고, Public Cloud인 AWS를 활용하여 Global한 서비스 환경에서 HPC/AI 학습·추론 환경을 빠르고 안전하게 구축하는 아키텍처 원칙과 실제 프로젝트에서 주의할 점을 차례로 설명 드리겠습니다.
시뮬레이션의 엔진에서 AI의 핵심 Infra로 확장
HPC(High Performance Computing)는 오랫동안 산업 현장의 문제를 해결하기 위한 핵심 엔진이었습니다. 자동차·항공 업계는 충돌 해석과 전산 유체역학(CFD)으로 시제품 제작 횟수를 줄였고, 반도체 업계는 회로 검증과 공정 시뮬레이션으로 제품의 완성도를 끌어올렸으며, 제약·바이오 업계는 분자 동역학과 유전체 분석으로 신약 후보 탐색 기간을 줄였습니다. 기상·에너지·금융 분야에서도 수천에서 수만 개의 코어를 동시에 써서 대규모의 복잡한 현상을 시뮬레이션하는 일은 이제 일상적인 업무입니다.
AI가 확산되면서 이 흐름에 새로운 변화가 추가 되었습니다. 대규모 언어 모델과 파운데이션 모델을 학습하려면 수백에서 수천 개의 GPU가 몇 주씩 하나의 작업을 함께 처리해야 합니다. 기술적으로 보면 노드 간 초고속 통신, 병렬 파일 시스템, Batch Job Scheduler를 갖춘 전형적인 HPC와 유사한 모습을 띄고 있습니다. 실제로 AI 학습 클러스터의 상당수는 HPC 진영에서 검증된 Slurm으로 Job을 관리합니다. Slurm을 개발해 온 SchedMD사는 2025년 12월 NVIDIA에 인수되었습니다. HPC 스케줄러가 AI 인프라의 핵심 구성 요소로 자리 잡았다는 상징적인 사건입니다.
■ AI를 위한 Infra는 '구성의 속도와 안정성, 운영의 효율'이 중요한 관점이 되었습니다.
AI의 눈부신 발전으로 인해 이제 현장의 질문이 바뀌었습니다. 몇 년 전까지는 "어떤 모델을 쓰는가?", "얼마나 빠른 계산 자원을 확보하는가?"가 관건이었습니다. Big Tech들은 경쟁적으로 새로운 거대 모델들을 발표하며, 다양한 형태의 오픈 모델이 쏟아지고, GPU 세대가 1~2년 주기로 바뀌는 지금은 "학습·추론 환경을 얼마나 빨리, 효율적으로 구성하고 안정적으로 운영하는가?"가 중요한 고려사항이 되었습니다. 같은 GPU를 갖고도 환경을 몇 주 만에 구성하여 GPU 활용률을 극대화하는 조직이 있는가 하면, 몇 달 동안 구축과 장애 대응을 반복하는 조직이 있습니다. 두 조직의 차이는 "대규모 Cluster를 효과적으로 구성하는 방법을 이해하고, 이를 제어하는 Control Plane들을 얼마나 꼼꼼한 아키텍처 위에 구성했는가"에서 나옵니다.
■ HPC/AI 학습·추론 환경이 Cloud와 통합될 때 얻을 수 있는 변화를 한 문장으로 정리한다면
많은 기업이 고성능 GPU를 포함한 HPC 노드를 On-Premise에 두고 운영합니다. 전력·냉각 설비 투자를 이미 했고, 장기간 고정 사용 시 단가가 낮으며, 데이터 Gravity나 Residency 제약이 있기 때문입니다. 반면 Control Plane, 인증, 데이터 보관, 보안 관제, 운영 자동화처럼 관리를 위한 영역은 Cloud의 유연성을 활용할 수 있습니다. 두 환경을 통합하여 다음과 같은 이점을 누릴 수 있습니다.
- 구축 속도: 스케줄러·인증·포털·모니터링을 IaC로 Cloud에 자원을 배포하고 새로운 Site에서는 연산 노드만 연결해 서비스에 필요한 준비 시간을 최소화할 수 있습니다.
- 글로벌 접근성: Global하게 구축된 Branch 사용자들이 같은 SSO, 같은 포털, 같은 정책으로 각 Site의 HPC 또는 GPU 자원을 활용할 수 있습니다.
- 탄력성: 피크 시점에는 AWS와 같은 Cloud로의 확장성을 활용하여 Job을 수행하는 Cloud 자원을 활용한 Bursting으로 대기 시간을 줄일 수 있습니다.
- 보안·감사의 일원화: Cloud의 관리형 보안 서비스로 여러 Site의 로그와 접근 이력을 좀더 쉽게 통합하고 관리하여 서비스의 신뢰도를 높일 수 있습니다.
■ HPC/AI 학습·추론 환경에서의 핵심 요구사항
시장에서 주목받는 HPC·AI 학습·추론 인프라의 변화는 Rack 단위로 커지는 GPU 시스템, 관리형 Slurm의 보편화, Slurm과 Kubernetes의 융합, On-Premise와 Cloud를 오가는 Hybrid 운영, 장애에 대응한 복원력 설계입니다. 이러한 변화 속에서 실제 현장에서 마주치는 핵심 요구사항은 다음과 같습니다.
| 요구사항 | 내용 | 설계에 주는 영향 |
|---|---|---|
| 데이터 레지던시(Data Residency) | 국가별 규제와 고객 계약상 데이터를 특정 국가·Site 밖으로 내보낼 수 없음 | 데이터는 Site에 두고 컴퓨팅이 데이터를 찾아가는 구조, Region 선택 제약 |
| 대용량 트래픽 | 수십~수백 TB의 학습 데이터와 해석 결과, 수 TB 단위 Checkpoint | 전용선(AWS DX등) 용량 산정, 데이터 계층 분리, 불필요한 지역 간 복제 억제 |
| Customizing의 유연성 | 프로젝트마다 다른 S/W 스택, 상용 라이선스, GPU 세대, 보안 요건 | 표준 Baseline 위에서 Site·프로젝트별 변수만 바꾸는 IaC/Ansible 구조 |
| 자원 배분의 공평성(Fairshare)과 우선순위 | 여러 Project가 한정된 GPU를 나눠 쓰므로 "누가 얼마나, 어떤 순서로" 쓸지에 대한 합의 필요 | 스케줄러의 Fairshare·QoS·Preemption 정책 설계, 사용량 기반 정산 |
특히 자원의 공평한 분배 부분은 기술보다 거버넌스의 고려가 필요한 문제입니다. AI시대의 GPU는 비싸고 항상 부족합니다. Project간 배분 기준이 없으면 "먼저 제출한 사람이 다 쓰는" 상태가 되거나, 반대로 GPU가 Idle한데도 할당량 때문에 쓰지 못하는 비효율이 생길수 있습니다. Fairshare로 장기적 공평성을 보장하고, QoS와 우선순위로 효과적인 대응이 가능한 정책이 처음부터 설계되어야 합니다.
1. HPC/AI Infra는 지금 어떻게 바뀌고 있는가: 2026년 주요 트렌드
Hyperion Research가 ISC 2026에서 발표한 바에 따르면, HPC와 AI for Science 시장은 2025년에 17% 성장해 약 700억 달러 규모에 이르렀습니다. 같은 기간 Cloud 기반 HPC·AI 관련 지출은 29.7% 늘어 124억 달러를 기록했습니다. 전체 시장은 2030년 약 1,400억 달러, Cloud 부문은 300억 달러 이상으로 커질 것으로 전망됩니다. Cloud 기반 HPC·AI 관련 지출 점유율은 AWS가 44.8%로 가장 높고, Google Cloud(19.7%)와 Microsoft Azure(18.7%)가 뒤를 잇습니다.
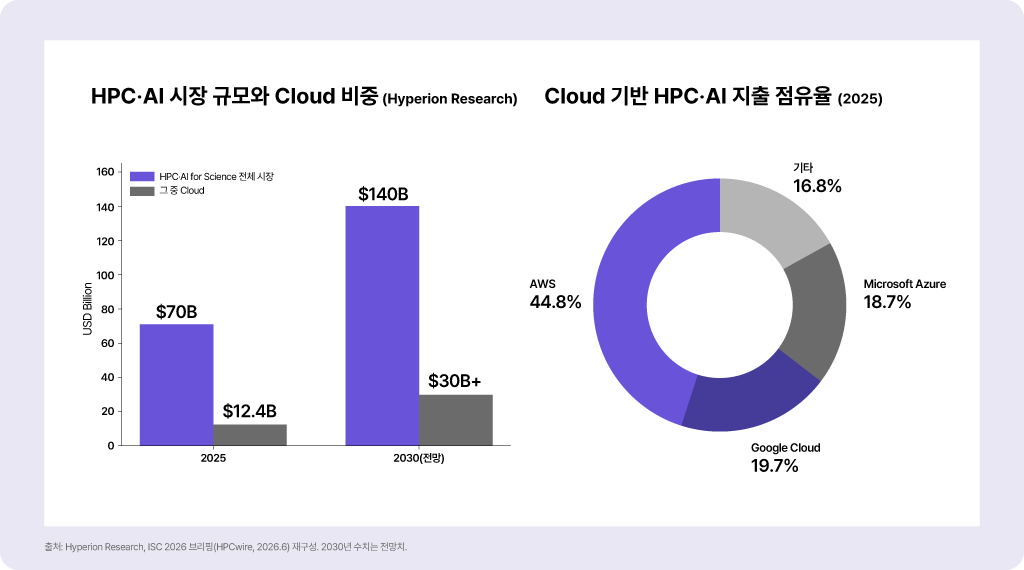
그림 1. HPC·AI 시장 규모와 Cloud 비중 (HPCwire, 2026.6.23)
■ 2026년 HPC·AI 학습·추론 인프라의 7가지 변화
| No. | 트렌드 | 주요 내용 | 아키텍처 시사점 |
|---|---|---|---|
| 1 | GPU 중심, Rack-scale 컴퓨팅 | AWS P6e-GB200 UltraServer는 72개의 Blackwell GPU를 하나의 NVLink 도메인으로 묶고, P6-B300은 인스턴스당 6.4Tbps EFA 네트워크를 제공 | 서버 단위가 아니라 Rack·UltraServer 단위로 Topology-aware 스케줄링 필요 |
| 2 | Managed Slurm의 보편화 | AWS PCS가 Slurm 25.11, Prometheus 호환 Metric, Scheduler Audit Log, 무중단 In-place Major Upgrade(최대 3개 버전)를 지원 | Control Plane을 직접 구축·운영하지 않고 관리형으로 위임하는 선택지가 현실화 |
| 3 | Slurm과 Kubernetes의 융합 | NVIDIA Slinky(Slurm Operator·Slurm Bridge) v1.0 공개, SageMaker HyperPod는 Slurm과 EKS 오케스트레이션을 모두 지원 | 학습은 Slurm, 추론·서비스는 K8s로 나누되 단일 제출 창구(Meta-scheduling)를 고려 |
| 4 | Hybrid와 Cloud Bursting | FSx for Lustre는 Direct Connect·VPN으로 On-Premise에서 마운트할 수 있고, S3 연동(DRA)으로 데이터 계층을 통합 | 데이터 중력(Data Gravity)을 고려해 컴퓨팅 위치를 결정 |
| 5 | 복원력 내재화 | 노드 장애 시 Job 자동 재큐잉·Auto-resume, 체크포인트 기반 학습 재개가 표준 기능으로 정착 | 장애를 막는 설계에서 장애가 나도 계속 도는 설계로 전환 |
| 6 | GPU 확보 전략의 다변화 | On-Demand 외에 Capacity Blocks for ML, Flexible Training Plans, ODCR 등 예약형 GPU 조달 확대 | Region 선택이 GPU 공급 가능성과 직결 |
| 7 | 보안·주권(Sovereignty) 강화 | NIST SP 800-53 Rev.5, CIS Benchmark 기반 Baseline과 데이터 주권 요구 확대 | 성능 최적화 예외(EFA 통신 등)를 보안 정책 안에서 문서화된 예외로 관리 |
이 변화를 한 문장으로 정리하다면 "HPC와 AI Infra간의 경계가 모호해지고, On-Premise/Cloud등 여러 위치와 형태의 자원들을 하나의 정책으로 묶어 관리 운영하는 안정적이고, 민첩한 서비스”를 시장은 요구하고 있다는 것입니다.
2. HPC와 AI 학습·추론 Workload의 특징
■ 공통점은 '대규모 병렬'과 '통신', 차이는 '최적화 목표'입니다
HPC 시뮬레이션과 AI 학습은 모두 수많은 노드가 하나의 작업을 나눠 처리합니다. 노드 간 통신 지연과 대역폭, 병렬 파일 시스템의 I/O 성능, Job Scheduler의 자원 배분 효율이 전체 성능을 결정합니다. 그래서 RDMA 계열 네트워크(InfiniBand, AWS EFA), Lustre 같은 병렬 파일 시스템, Slurm이나 LSF 같은 Batch Scheduler를 활용합니다.
| 항목 | HPC | AI 학습·추론 |
|---|---|---|
| 핵심 목표 | 연산 성능 및 작업 완료 | 학습·추론 성능과 서비스 품질 |
| 주요 자원 | CPU중심, 메모리, 네트워크 | GPU 중심, GPU 메모리, 데이터 |
| 운영 방식 | Job 기반 Batch 처리 | 학습: Batch 형태의 Job 수행, ·추론: 실시간 요청 대응 |
| 성능 지표 | 처리 시간, Job 성공률 | GPU 활용률, 학습 시간, 추론 지연 |
| 안정성 | 장애 복구 및 작업 재시작 | 자동 복구, 학습 재개, 서비스 연속성 |
| 일반적 통신 패턴 | MPI 기반 이웃 노드 간 Point-to-Point 통신 중심 | NCCL 기반 All-Reduce·All-to-All 등 Collective 통신 중심 |
| Storage I/O | 대용량 입력 Read, 결과 파일 Write | 수많은 작은 파일 Random Read + 주기적 대용량 Checkpoint Write(학습) |
| 주요 소프트웨어 스택 | 상용 해석 S/W(라이선스 서버 의존), 컴파일러, MPI | 컨테이너(NGC), PyTorch, CUDA, 드라이버 버전 정합성 |
3. On-Premise의 Computing Power와 Cloud의 유연성
"전부 Cloud로 옮길 것인가, On-Premise를 유지할 것인가"는 더 이상 좋은 질문이 아닙니다. 대규모 GPU·HPC 자원에 대해 두 환경의 장점을 최대한 활용하는 것에 집중 하는 것입니다.
■ 3.1 고정비의 On-Premise + 유연한 Cloud = 가동시간 극대화
On-Premise GPU·HPC 클러스터는 초기 투자 후 고정비로 운영되므로 가동률이 높을수록 단가가 낮아지고, InfiniBand와 전용 병렬 파일 시스템으로 예측 가능한 최고 성능을 냅니다. 반면 장비 증설에는 수개월이 걸리고, 수요가 몰리면 대기열이 길어집니다. 특히 지금과 같은 GPU 품귀나 Memory 반도체의 가격이 고공행진을 멈추지 않는 상황에는 Cloud를 활용하여 자원을 유연하게 늘리고 줄일 수도 있습니다.
■ 3.2 상황에 따라 Cloud 자원의 동적 활용: Cloud Bursting
Cloud Bursting은 On-Premise 대기열이 일정 수준을 넘으면 AWS에 Compute Node를 동적으로 띄워 Job을 처리하고, 작업이 끝나면 노드를 자동으로 반납하는 방식입니다.
| 구현 방식 | 동작 | 적합한 경우 |
|---|---|---|
| Slurm Elastic(Power Saving) 노드 | ResumeProgram/SuspendProgram으로 AWS 노드를 Partition에 동적 추가·제거 | 단일 Slurm 클러스터에 Cloud Partition을 덧붙이는 구조 |
| Slurm Federation / Multi-cluster | On-Premise 클러스터와 AWS 클러스터(PCS 등)를 연합, Job을 가용 클러스터로 전달 | Site·Cloud 클러스터를 독립 운영하면서 Job만 넘기는 구조 |
| IBM LSF Resource Connector | 대기 Job 수요에 따라 AWS 인스턴스를 자동 생성해 LSF 클러스터에 편입 | 기존 LSF 기반 EDA·CAE 환경 |
| Meta-scheduler / 포털 | 사용자는 하나의 창구로 제출, 정책 엔진이 실행 위치 결정 | 여러 스케줄러가 섞인 대규모 조직 |
Bursting 대상은 데이터 의존성이 낮고, 레지던시 제약이 없고, 노드 간 통신이 Job 안에서 끝나는 Workload가 적합합니다. 파라미터 스윕, 회귀 테스트, 독립적인 추론 배치, 소규모 Fine-tuning이 대표적입니다. 반대로 레지던시 제약이 있는 데이터나 수백 TB 입력을 쓰는 학습이나 HPC의 Job은 Partition·Feature·License 조건을 활용하여 On-Premise에 남기는 정책을 스케줄러 수준에서 관리하는 것이 효율적입니다.
■ 3.3 상용 License가 필요한 환경: License와 자원의 가용성을 함께 고려한 효율 관리
반도체 EDA, CAE 해석, 일부 AI 상용 S/W 환경에서는 GPU·CPU보다 License에 제약이 있는 경우가 많습니다. 노드는 비어 있는데 License가 없어 Job이 실패하거나, License는 남는데 노드가 없어 대기하는 상황은 모두 큰 낭비입니다. Hybrid 환경에서는 실행 위치가 늘어나는 만큼 이 문제가 자원의 효율적인 활용을 막는 중요한 요소가 될수 있습니다.
| 관리 포인트 | 내용 | 구현 예시 |
|---|---|---|
| License를 스케줄링 자원으로 등록 | 스케줄러가 License 수량을 알고, License가 확보될 때만 Job을 시작 | Slurm Licenses= 및 sacctmgr로 원격 License 자원 관리 / LSF License Scheduler |
| License 서버 실사용량과 동기화 | FlexLM 등 License 서버의 실제 Check-out 수와 스케줄러의 수치를 주기적으로 맞춤 | lmstat 수집 → 스케줄러 License Count 갱신 |
| 프로젝트별 License 배분 | 프로젝트별 License 보장량과 공유량을 정의 | LSF License Scheduler 프로젝트 모드, Slurm QoS의 License 한도 |
| Cloud Bursting 조건에 License 포함 | AWS 노드를 띄우기 전에 해당 Job의 License 확보 여부를 먼저 확인 | License 부족 시 Burst 억제 → 불필요한 인스턴스 비용 방지 |
| License 약관 확인 | Cloud·해외 Site에서의 사용 허용 범위(지역·호스트 제한) 확인 | 벤더 계약 사전 검토 |
4. 효율적인 Job 관리를 위한 준비 : 주요 Job Scheduler 비교와 Fairshare·우선순위 관리
대규모 HPC·AI 환경의 Job Scheduler는 사실상 IBM Spectrum LSF와 Slurm 두 축으로 나눌 수 있습니다. 둘 다 수만 노드 규모를 운영할 수 있는 검증된 제품이지만, 출발점과 활용의 측면에서 차이가 있습니다.
■ 4.1 도입·비즈니스 모델과 스케줄링 기능 비교
① 도입·비즈니스 모델
| 비교 항목 | IBM LSF | Slurm |
|---|---|---|
| 라이선스 | 상용 소프트웨어 | 오픈소스(GPL) |
| 개발·공급 | IBM | 오픈소스 커뮤니티 / SchedMD(2025년 12월 NVIDIA 인수) |
| 도입 비용 | 라이선스 및 유지보수 비용 | 소프트웨어 라이선스 비용 없음 |
| 기술 지원 | IBM 상용 기술 지원 | 커뮤니티 또는 SchedMD 상용 지원 |
| 벤더 종속성 | 상대적으로 높음 | 상대적으로 낮음 |
| 주요 시장 | 기업 HPC, EDA, 엔지니어링 | 슈퍼컴퓨팅, 연구 HPC, AI |
② 스케줄링·자원 관리
| 비교 항목 | IBM LSF | Slurm |
|---|---|---|
| Job Scheduling | 다양한 정책, SLA 기반 스케줄링 | 우선순위(Multifactor), Fair-share, Backfill |
| GPU 관리 | NVIDIA/AMD GPU, GPU 공유 및 할당 | GPU GRES, MIG, MPS, GPU 바인딩 |
| 상용 SW 라이선스 관리 | 전용 License Scheduler 제공 | License 자원 관리 기능 제공 |
| 주요 특징: LSF는 비용을 내고 책임 있는 지원과 검증된 정책 기능을 얻는 모델입니다. Slurm은 라이선스 비용 없이 개방형 생태계를 활용하는 모델이며, AI 진영의 사실상 표준으로 자리 잡았습니다. 스케줄링 측면에서 LSF는 SLA·License 중심의 기업형 정책 운영에, Slurm은 GPU를 세밀하게 나누고(MIG·MPS) 대규모 병렬 Job을 빈틈없이 채우는(Backfill) 데 강점이 있습니다. |
■ 4.2 운영 시나리오별 선택 가이드
| 운영 시나리오 | 상대적 우위 | 이유 |
|---|---|---|
| 반도체 EDA 및 설계 자동화 | LSF | 상용 툴 라이선스와 정책 중심 운영 |
| 대규모 MPI 과학 계산 | Slurm | HPC 생태계와 대규모 병렬 작업 |
| AI 모델 학습용 GPU 팜 | Slurm | GPU 자원 관리, 개방형 생태계 |
| 다수 사업부의 SLA 관리 | LSF | 기업 정책 및 계층적 자원 배분 |
| 제한된 IT 예산 | Slurm | 라이선스 비용 절감 |
| Linux/Windows 등 이기종 시스템 | LSF | 상대적으로 넓은 플랫폼 지원 |
| 소스 코드 수준의 기능 개발 | Slurm | 오픈소스 확장 가능 |
| AWS 관리형 서비스 중심 Hybrid | Slurm | PCS·HyperPod 등 관리형 Control Plane 활용 |
실무에서는 EDA·CAE는 LSF, AI 학습 GPU 팜은 Slurm처럼 Workload 특성에 맞춰 두 스케줄러를 함께 운영할수 있습니다. 이때 통일해야 할 것은 스케줄러가 아니라 사용자 ID(IdM), Project 코드, 사용량 정산 기준입니다.
■ 4.3 Project 간 자원 배분의 공평성(Fairshare)과 우선순위 관리
GPU를 여러 Project가 나눠 쓸 때 스케줄러 정책은 곧 조직의 자원 배분 규칙을 정의하는 것입니다.
| 정책 계층 | 역할 | Slurm 구현 | LSF 구현 |
|---|---|---|---|
| 보장·한도 (Quota) | Project별로 최소 보장량과 최대 사용량을 정함 | Association·QoS의 GrpTRES(예: gres/gpu=64), MaxTRESPerUser | Queue·User Group별 Slot/GPU 한도, Guaranteed Resource Pool |
| 공평성 (Fairshare) | 최근 많이 쓴 Project의 우선순위를 낮춰 장기적으로 배분 비율을 맞춤 | Multifactor Priority + Fair Tree, PriorityDecayHalfLife로 과거 사용량 감쇠 | 계층형 Fairshare(사업부 → 팀 → 사용자) |
| 우선순위·선점 (Priority·Preemption) | 긴급 과제와 서비스성 Job을 앞당기고, 필요하면 저우선 Job을 중단 | QoS Priority, PreemptType=preempt/qos, Requeue | Queue Priority, SLA 기반 스케줄링, Preemptive Queue |
5. 아키텍처의 중요성: Global Hybrid HPC/AI 학습·추론 Infra 설계 원칙
여러 지역의 고객 환경과 On-Premise, Cloud를 함께 쓰는 환경에서 아키텍처 결함은 성능 저하에 그치지 않습니다. 인증 지연으로 인한 로그인 장애, 노드 연결 실패에 따른 Job 실패, 데이터 동기화 충돌로 인한 결과물 손실 등 운영 장애로 이어집니다.
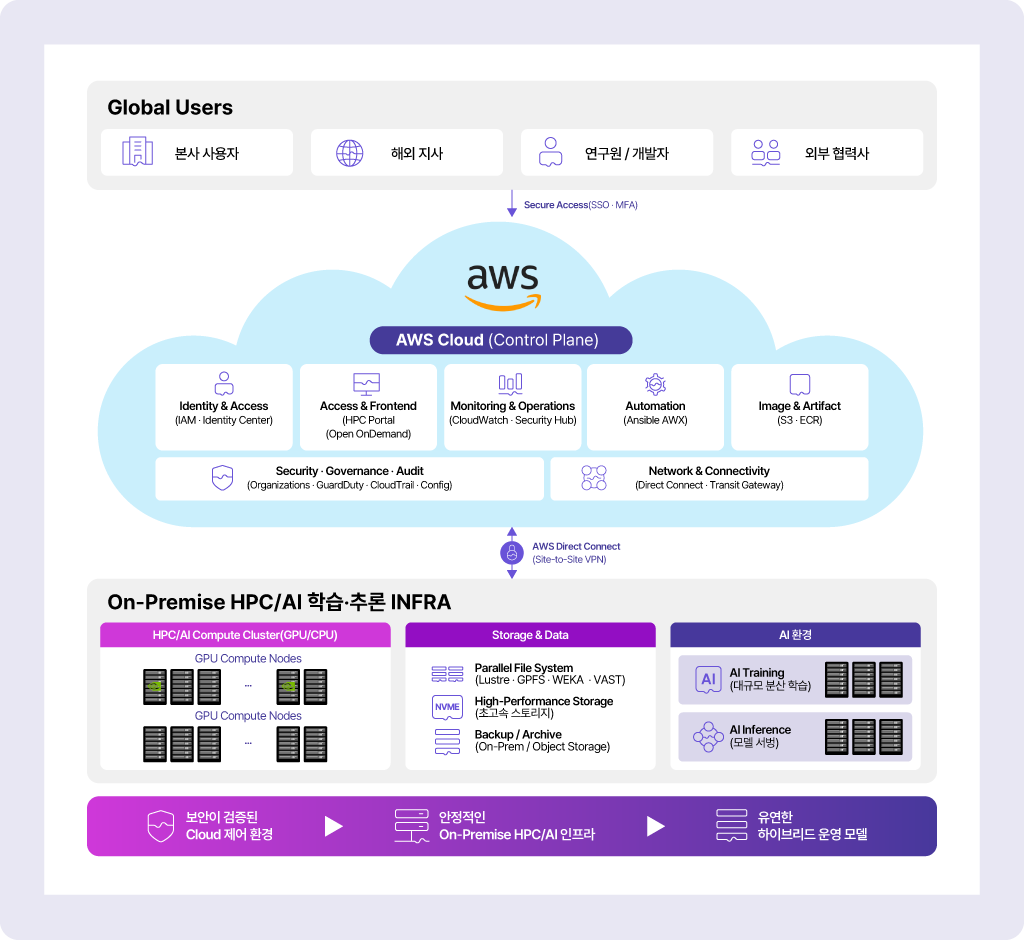
이 글에서 중심으로 다루는 참조 아키텍처는 GPU·HPC 연산 노드와 고성능 병렬 파일 시스템(Lustre, GPFS, WEKA, VAST 등)은 각 고객 Site의 On-Premise에 두고, 스케줄러 Control Plane, 인증(IdM·SSO), 로그인·포털, License 서버, 데이터 보관(S3), 보안 관제, 운영 자동화는 모두 Site와 가까운 AWS Region에 두는 형태입니다. 두 영역은 이중화된 Direct Connect로 연결하고, 피크 수요는 같은 Control Plane에서 AWS의 Burst Compute로 넘깁니다.
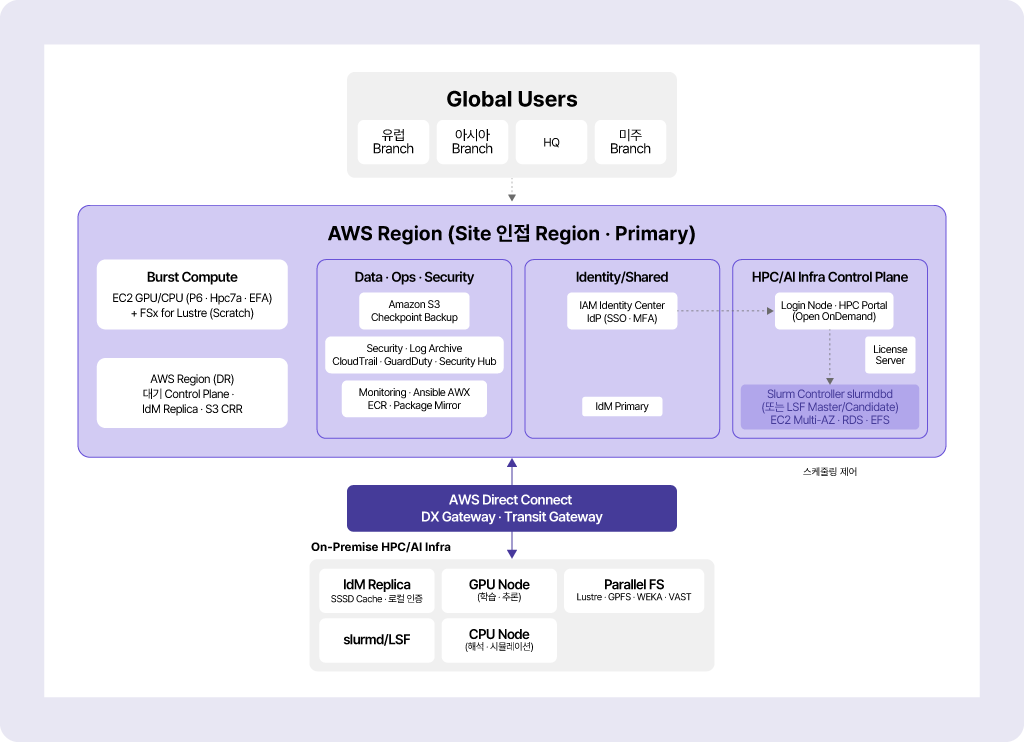
그림 2. Global Hybrid HPC/AI 학습·추론 참조 아키텍처 (AWS 기반)
■ 5.1 Global Branch가 함께 일하는 공유 체계: Source와 산출물을 어디에 둘 것인가?
글로벌 협업의 첫 번째 과제는 "모든 사람이 같은 데이터를 보되, 모든 데이터를 모든 곳에 복제하지는 않는 것"입니다. 수~수십 TB짜리 시뮬레이션 결과와 학습 데이터셋을 지역마다 복사하면 비용과 정합성 문제가 함께 커집니다. 데이터의 성격에 따라 계층을 나누어야 합니다.
| 데이터 계층 | 예시 | 권장 저장소 | 공유 방식 |
|---|---|---|---|
| Source·설정 | 해석 Input Deck, 학습 코드, Ansible Role | Git(사내 GitLab/GitHub Enterprise), CodeCommit 대체 저장소 | 지역별 Mirror + PR 기반 변경 |
| Artifact·패키지 | 컨테이너 이미지, Python/Conda 패키지 | Amazon ECR(Cross-Region Replication), 사내 Nexus/Artifactory | Pull-through Cache, 승인된 Mirror만 허용 |
| Hot 작업 데이터 (On-Premise) | Job 실행 중 Scratch, 학습 배치 데이터 | Site 병렬 FS(Lustre, GPFS, WEKA, VAST) | 연산 노드와 같은 Fabric(InfiniBand/RoCE)에 배치, 결과만 S3로 반출 |
| Hot 작업 데이터 (Burst) | Cloud Bursting Job의 입력·Scratch | FSx for Lustre(Scratch) | Burst 노드와 같은 AZ, 필요한 입력만 S3에서 Lazy Load, Job 종료 후 삭제 |
| 공유 Home·프로젝트 | 사용자 Home, 공용 Script | Amazon EFS 또는 FSx for NetApp ONTAP | Region 내 공유, 타 지역은 Read-only 사본 |
| 원천·산출물(System of Record) | 원천 데이터, 최종 결과, 체크포인트, 모델 | Amazon S3(버전 관리·Object Lock) | Multi-Region Access Point, CRR(필요 데이터만) |
| 반출 제한 데이터 | 국가 규제·고객 기밀 데이터 | On-Premise 병렬 FS | Site 로컬 자원에서 실행 |
System of Record를 하나로 관리(S3 또는 지정된 On-Premise 저장소), Hot 데이터는 컴퓨팅 자원 가까이에 배치, 지역 간 이동은 명시적인 Pipeline(AWS DataSync, S3 Replication)등을 활용하는 정책을 고려해야 합니다.
■ 5.2 신속한 Control Plane의 구축
Control Plane은 로그인 노드, Slurm Controller(slurmctld), Accounting DB(slurmdbd), 인증(IdM), 라이선스 서버, 모니터링, AI 서비스를 위한 Kubernetes API Server와 MLOps 등이 포함됩니다. 이 영역을 수작업으로 구축하면 몇 주가 걸리지만, 관리형 서비스와 IaC를 함께 쓰면 소요 시간을 크게 단축할 수 있습니다.
일반적인 AWS PCS(Parallel Computing Service)나 SageMaker HyperPod 같은 관리형 서비스는 EC2 기반 Compute Node(GPU/HPC등) 관리를 전제로 합니다. 따라서 연산 노드가 On-Premise에 있는 시나리오에서는 EC2 위에 Slurm/LSF를 Terraform·Ansible로 구축하는 Self-managed 방식을 중심으로 살펴보겠습니다. 관리형 서비스는 Cloud Bursting이나 Cloud 전용 클러스터에 활용할 수 있습니다.
| 구축 방식 | 특징 | 적합한 상황 | 유의 사항 |
|---|---|---|---|
| EC2 자체 구축 Slurm/LSF + IaC | slurmctld·slurmdbd(또는 LSF Master)를 EC2 Multi-AZ에 배치, RDS·EFS로 상태 저장, Terraform·Ansible로 반복 구축 | On-Premise 연산 노드를 Cloud Control Plane에서 제어 | Controller HA·업그레이드·패치는 직접 책임, DX 품질이 서비스 품질을 좌우 |
| EC2 직접 구축 + NVIDIA BCM | On-Premise와 동일한 클러스터 관리 도구로 Hybrid 통합 | On-Premise DGX/GPU 클러스터와 Cloud를 함께 관리 | BCM 무상 라이선스는 지원 미포함, 엔터프라이즈 지원은 별도 계약 |
| Amazon EKS (+ Slinky) | 컨테이너 기반 학습·추론 통합 운영 | 추론 서비스, MLOps 중심 조직 | Multi-tenant 격리 설계 난이도 높음 |
■ 5.3 Node 간 통신: 안정적인 고성능 네트워크
| 구간 | 권장 구성 | 설계 포인트 |
|---|---|---|
| AWS 내 Compute ↔ Compute | EFA(Elastic Fabric Adapter), Cluster Placement Group, 단일 AZ | 대규모 MPI/NCCL Job은 반드시 같은 AZ·같은 Placement Group에 배치 |
| UltraServer 내부 | NVLink 도메인(최대 72 GPU) | Slurm Topology Plugin으로 같은 도메인 내 배치 우선 |
| Compute ↔ Storage | FSx for Lustre(같은 AZ), EFA 지원 Client | Throughput 등급을 GPU 수에 비례해 산정 |
| On-Premise ↔ AWS | AWS Direct Connect 이중화(서로 다른 Location 2회선 이상) + Site-to-Site VPN 백업 | 회선 장애 시 인증·스케줄러 통신 경로가 유지되는지 검증 |
| Region ↔ Region / Site ↔ Site | Transit Gateway Inter-Region Peering, Cloud WAN | 대용량 데이터는 업무 시간 외 Batch 전송, QoS 분리 |
| On-Premise 내부 | InfiniBand(NDR/XDR) 또는 RoCE | Cloud와 MPI 단일 Job으로 수행은 지양(지연 차이 수십~수백 배) |
■ 5.4 Control Plane과 Work Node 사이의 Latency와 Delay
Control Plane과 Compute Node 사이의 거리는 생각보다 많은 것에 영향을 줍니다. Job Scheduler인 Slurm을 예로 들면 Controller는 노드와 주기적으로 상태를 주고받습니다. 노드는 로그인과 Job 실행 시점마다 IdM에 사용자·그룹을 조회하고, 라이선스 기반 S/W는 실행 중에도 라이선스 서버와 Heartbeat를 주고받습니다. 사용자의 수가 많거나 복잡한 환경일수록 Latency의 영향도 커질수 있습니다. 물론 절대적인 수치이기 보다는 업무의 성격에 따라 해당 영향을 적절히 고려하여 설계에 반영하는 것이 중요합니다.
| 통신 구간(참고 범위) | 왕복 지연(RTT) | 허용 가능한 기능 |
|---|---|---|
| 같은 AZ 내부 | 1ms 미만 | 모든 Control Plane 기능 |
| 같은 Region, 다른 AZ | 약 1~2ms | Slurm Controller HA, IdM 복제, DB Multi-AZ |
| 인접 Region(예: 서울↔도쿄) | 약 20~40ms | IdM 복제, 데이터 복제, 모니터링 수집 |
| 대륙 간(예: 서울↔미국 동부·유럽) | 약 150~250ms | IdM 복제(비동기), 데이터 Batch 전송만 권장 |
※ 지연시간(RTT) 수치는 설명을 위한 일반적인 참고 범위의 예시이며, 실제 값은 회선·경로·Region 조합에 따라 다를 수 있음
설계 원칙
- Control Plane은 각 On-Premise Site와 가장 가까운 AWS Region에 둡니다. 같은 국가·권역의 Region과 Direct Connect로 연결하면 RTT를 수 ms 수준으로 유지할 수 있고, 이 정도면 Slurm·LSF 제어 통신에 문제가 없습니다. 반대로 대륙 간 지연이 있는 Site의 노드를 원격 Controller에 붙이면 SlurmdTimeout·MessageTimeout을 늘려야 하고, 일시적 지연에도 노드가 DOWN으로 처리되어 Job이 실패할 수 있습니다. 이런 경우가 예상되면 인접 Region에 Site별 Control Plane을 두고 Federation(Slurm Federation, LSF Multi-cluster, Meta-scheduler)으로 묶는 구조가 안전합니다.
- DX 장애에도 실행 중인 Job은 계속 수행되어야 합니다. Slurm은 Controller와 통신이 끊겨도 실행 중인 Job은 노드에서 계속 수행되고, 신규 스케줄링만 멈춥니다. 다만 SlurmdTimeout을 DX 절체 시간보다 충분히 길게 잡아야 노드가 강제로 DOWN 처리되지 않습니다.
- License 서버는 AWS Multi-AZ에 두되, 모든 실행 위치에서의 지연을 확인해야 합니다. 일부 상용 S/W는 실행 중에도 License Heartbeat를 주고받으므로, 대륙 간 Check-out이 필요한 Site에는 지역 License 서버를 별도로 두는 것도 고려해야 합니다.
■ 5.5 일부 Node의 장애에 대응한 HA 설계
| 구성 요소 | 단일 장애 시 영향 | HA 설계 방법 |
|---|---|---|
| slurmctld | 신규 Job 제출·스케줄링 중단 | SlurmctldHost 다중 지정(Primary/Backup), StateSaveLocation을 공유 스토리지(EFS)에 배치. |
| slurmdbd / Accounting DB | 사용 이력·Fairshare 계산 중단 | Amazon RDS/Aurora Multi-AZ, slurmdbd 이중화 |
| IdM(FreeIPA) | 로그인·Job 실행 실패 | Site·AZ마다 최소 2대, SSSD Failover 서버 지정 |
| Login Node | 사용자 접속 불가 | 2대 이상 + NLB 또는 Open OnDemand Portal 이중화 |
| Compute Node | 실행 중인 Job 실패 | Node Health Check(NHC, DCGM 진단), 자동 Drain·교체, Job 자동 재큐잉 |
| AI 학습 Job | 수천 GPU 작업 전체 중단 | 주기적 Checkpoint(Site 병렬 FS → S3), 학습 프레임워크의 자동 재개(Auto-resume), Spare Node 확보 |
| Storage | 전체 Job I/O 중단 | Site 병렬 FS의 메타데이터·스토리지 서버 이중화, S3를 System of Record로 두고 Scratch는 재생성 가능하게(Burst 환경은 FSx Persistent 유형) |
| 네트워크(DX) | Cloud Control Plane과 On-Premise 노드 간 통신 두절 → 신규 스케줄링·License Check-out 중단 | 서로 다른 DX Location으로 2회선 이상 + Site-to-Site VPN 백업, 실행 중 Job 보호를 위한 Timeout 설정, 장기 단절 대비 Site 로컬 비상 Controller(Cold Standby)와 필요시 IdM Replica(On-Premise) |
HA 설계의 목표는 장애가 발생하더라도 영향을 최소화 하는 것입니다. AI 학습에서는 체크포인트 주기가 곧 "장애 시 해당 Checkpoint로 되돌아 가서 새롭게 시작해야하는 시간"이 되므로, GPU 규모가 클수록 체크포인트 저장 시간과 주기를 Storage의 성능, 용량등과 함께 최적화해야 합니다.
6. 다수의 사용자가 있는 대규모 Cluster의 User 및 권한 관리
■ 6.1 계정 관리의 필요성
HPC 클러스터에서 사용자 계정은 로그인 ID에 그치지 않습니다. 공유 파일 시스템의 파일 소유권(UID/GID), 스케줄러의 자원 할당 단위(Slurm Account), 사용량 정산 단위가 모두 계정에 묶여 있습니다. Site마다 계정을 따로 만들면 같은 사람이 Site마다 다른 UID를 갖게 되고, 공유 스토리지의 파일 권한이 꼬이며, 퇴사자 계정이 일부 클러스터에 남는 보안 사고로 이어집니다.
따라서 대규모 Global 클러스터는 다음 원칙을 지켜야 합니다.
- 단일 ID 관리 체계: 모든 Site와 Cloud가 같은 IdM(또는 IdM 연합)을 기준으로 UID/GID를 사용합니다.
- 계정 수명주기 자동화: 입사·이동·퇴사(Joiner–Mover–Leaver) 이벤트가 인사 시스템이나 기업 IdP에서 IdM, 다시 Slurm Account로 자동 전파되게 합니다.
- 인증과 인가의 분리: "누구인가"(IdM)와 "무엇을 얼마나 쓸 수 있는가"(Scheduler), "무엇을 운영할 수 있는가"(Platform)를 계층별로 관리합니다.
■ 6.2 관리의 구조화: 3계층 모델
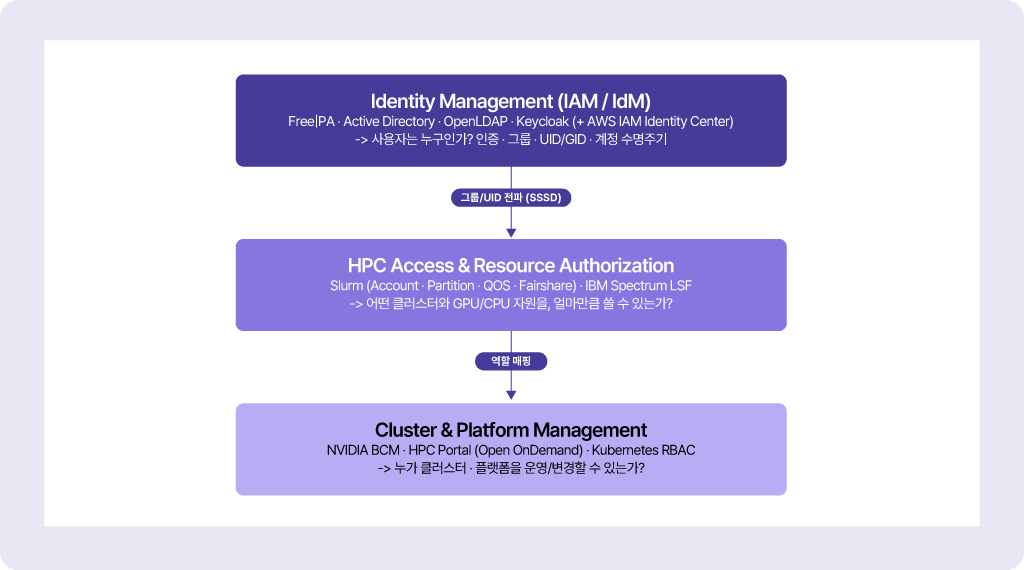
그림 3. 대규모 Cluster 사용자·권한 관리의 3계층 구조
| 계층 | 대표 솔루션 | 답해야 할 질문 | 주요 관리 대상 |
|---|---|---|---|
| Identity Management (IAM / IdM) | FreeIPA · Active Directory · OpenLDAP · Keycloak | 사용자가 누구인가? | 인증(Kerberos/LDAP/OIDC), 그룹, UID/GID, 계정 수명주기, MFA, HBAC·sudo 정책 |
| HPC Access & Resource Authorization | Slurm · IBM Spectrum LSF | 어떤 클러스터와 GPU/CPU 자원을 사용할 수 있는가? | Slurm Account·Association, Partition, QoS, Fairshare, GPU 할당 한도, LSF Queue·User Group |
| Cluster & Platform Management | NVIDIA BCM · HPC Portal(Open OnDemand 등) · Kubernetes RBAC | 클러스터·플랫폼에 접근하고 운영할 권한이 있는가? | 노드 관리·이미지 배포 권한, Portal 접근, Namespace·Role, 운영자 권한 분리 |
AWS 환경에서는 AWS IAM Identity Center를 통해 AWS Console·API, 즉 Cloud 자원을 다루는 권한을 관리합니다. HPC나 AI 학습·추론 클러스터 OS에 로그인하는 사용자 계정은 IdM(혹은 LDAP등)을 통해 관리합니다. 두 체계를 같은 기업 IdP에 연결하되 권한 범위는 분리하는 것을 원칙으로 해야 합니다.
■ 6.3 상황별 Solution 구성
| 도입 환경 | 권장 조합 | 선택 이유 및 비고 |
|---|---|---|
| 일반 Linux HPC | FreeIPA + Slurm | 오픈소스 조합, Kerberos·LDAP·DNS·CA 통합, HBAC로 노드 접근 제어 |
| 기업 내부 HPC | Active Directory + FreeIPA/SSSD + Slurm | 기업 AD를 원장으로 유지하고 FreeIPA AD Trust로 POSIX 속성 관리, SSSD로 노드 연동 |
| NVIDIA GPU 기반 AI/HPC | NVIDIA BCM + LDAP/AD + Slurm | BCM이 노드 프로비저닝·Slurm 구성을 통합 관리, DGX/SuperPOD 표준 구성 |
| Cloud Native AI 플랫폼 | Keycloak/기업 IdP + Kubernetes RBAC + GPU 스케줄러 | OIDC 기반 SSO, Namespace 단위 Multi-tenancy, Kueue·Volcano 등으로 GPU Quota 관리 |
| 대규모 연구기관 HPC | FreeIPA 또는 연합 IAM + Slurm + CILogon | 기관 간 연합 인증(InCommon/eduGAIN), 외부 협력 연구자 계정 관리 |
| Global Hybrid (본 글의 전제) | 기업 IdP(AD/Entra ID) + FreeIPA Multi-Region Replica + Slurm(EC2 Self-managed) + IAM Identity Center | 사용자 ID는 IdM으로 통일하고, Cloud 운영 권한은 Identity Center Permission Set으로 분리 |
7. 기밀 정보를 위한 Cloud 보안: NIST 기반 Security Baseline을 HPC/AI 학습·추론 환경에 적용하기
■ 7.1 'Baseline'의 고려
반도체 설계 데이터, 신약 후보 물질, 자율주행 학습 데이터, 국방·항공 해석 모델처럼 기밀성이 높은 산업에서 HPC 데이터는 그 자체가 기업의 핵심 자산입니다. 그런데 HPC/AI 학습·추론 환경은 일반 업무 시스템보다 보안 사각지대가 생기기 쉽습니다. 성능을 위해 노드 간 통신을 넓게 열어 두고, 외부 패키지를 자유롭게 설치하길 원하며, 수천 대의 노드가 빠르게 생성되고 사라지는 특성을 가지고 있기 때문입니다.
그래서 프로젝트 착수 시점에 Security Baseline을 확정하고, 성능상 필요한 예외는 문서화해 승인받는 접근이 필요합니다. 아래 내용은 NIST SP 800-53 Rev.5에 맞춘 AWS Security Baseline을 7개 영역으로 나누어, 항목별 NIST Control, AWS 서비스, 적용 방법, HPC/AI 학습·추론 환경의 고려사항을 정리한 것입니다.
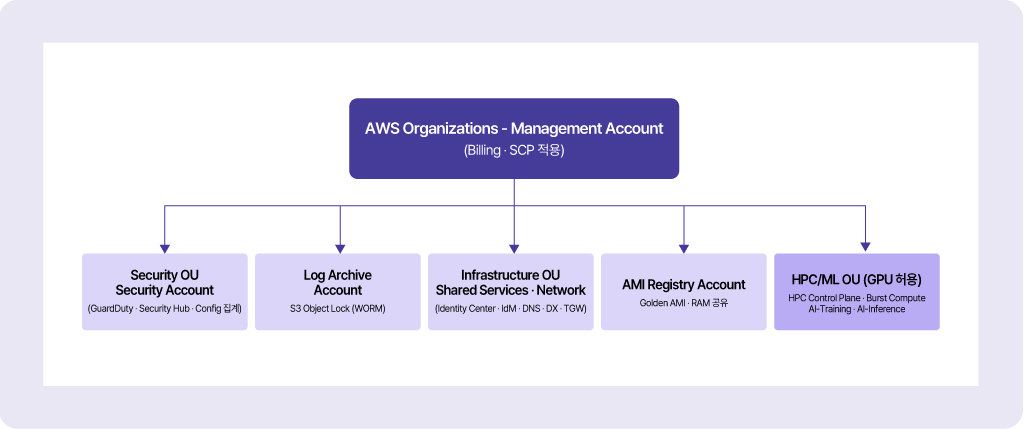
그림 4. HPC/AI 학습·추론을 위한 AWS Multi-Account 보안 구조
■ 7.2 Cloud 기반 환경의 Security Baseline 한눈에 보기
| 영역 | NIST SP 800-53 Controls | 핵심 AWS 서비스 | 목표 |
|---|---|---|---|
| Account Provisioning & IAM | AC-2, AC-3, AC-6, IA-2, IA-5, IA-8, SC-28 | AWS Organizations, SCP, IAM Identity Center, IAM Access Analyzer | 계정 구조 분리, 최소 권한, 장기 자격 증명 제거 |
| VPC Architecture & Network Segmentation | SC-7, SC-8, AC-4, CA-9, SI-4 | Amazon VPC, Transit Gateway, NAT Gateway, VPC Flow Logs, VPC Endpoints | 경계 보호, 내부 연결 통제, 트래픽 가시성 |
| Logging & Monitoring | AU-2, AU-3, AU-6, AU-9, AU-11, AU-12, SI-4 | CloudTrail, AWS Config, Security Hub, GuardDuty, S3 Object Lock | 감사 증적 확보·보호, 위협 탐지 |
| Firewall & Security Groups | SC-7, AC-4, SI-3 | Security Group, NACL, AWS Network Firewall, AWS WAF | 다층 방어, 출구(Egress) 통제 |
| Protocol Usage Controls | SC-8, SC-23, IA-3, CM-7 | ACM/ELB TLS Policy, SSM Session Manager, Route 53 Resolver DNS Firewall | 전송 구간 암호화, 안전하지 않은 프로토콜 제거 |
| AMI Hardening (CIS Benchmarks) | CM-2, CM-6, CM-7, SI-2, SA-10 | EC2 Image Builder, Amazon Inspector, AWS RAM, IMDSv2 | 표준 이미지, 설정 기준선, 취약점 관리 |
| Package Manager Restrictions | CM-7, CM-11, SA-10, SI-3 | SSM State Manager·Patch Manager·Inventory, Network Firewall, CodeArtifact/ECR | 공급망 보안, 승인된 저장소만 허용 |
■ 7.3 NIST Control 주요 내용
| Control | 명칭 (NIST SP 800-53 Rev.5) | 의미 |
|---|---|---|
| AC-2 | Account Management | 계정의 생성·변경·비활성화·삭제 관리 |
| AC-3 | Access Enforcement | 승인된 접근만 허용하도록 강제 |
| AC-4 | Information Flow Enforcement | 시스템 간·내부 정보 흐름 통제 |
| AC-6 | Least Privilege | 최소 권한 원칙 |
| IA-2 | Identification and Authentication (Organizational Users) | 내부 사용자 식별·인증(MFA 포함) |
| IA-3 | Device Identification and Authentication | 장치·서비스 식별·인증 |
| IA-5 | Authenticator Management | 비밀번호·키·토큰 등 인증 수단 관리 |
| IA-8 | Identification and Authentication (Non-Organizational Users) | 외부 사용자·연합 사용자 인증 |
| SC-7 | Boundary Protection | 네트워크 경계 보호 |
| SC-8 | Transmission Confidentiality and Integrity | 전송 데이터 기밀성·무결성 |
| SC-23 | Session Authenticity | 세션 진위성 보호 |
| SC-28 | Protection of Information at Rest | 저장 데이터 보호(암호화) |
| CA-9 | Internal System Connections | 내부 시스템 간 연결 승인·통제 |
| AU-2 / AU-3 / AU-12 | Event Logging / Content of Audit Records / Audit Record Generation | 감사 대상 이벤트 정의·기록 내용·생성 |
| AU-6 | Audit Record Review, Analysis, and Reporting | 감사 기록 검토·분석·보고 |
| AU-9 | Protection of Audit Information | 감사 기록의 위·변조 및 삭제 방지 |
| AU-11 | Audit Record Retention | 감사 기록 보존 |
| SI-2 / SI-3 / SI-4 | Flaw Remediation / Malicious Code Protection / System Monitoring | 취약점 조치 / 악성코드 방어 / 시스템 모니터링 |
| CM-2 / CM-6 / CM-7 | Baseline Configuration / Configuration Settings / Least Functionality | 기준 구성 / 보안 설정 / 불필요 기능 제거 |
| CM-11 | User-Installed Software | 사용자 설치 소프트웨어 통제 |
| SA-10 | Developer Configuration Management | 개발·빌드 과정의 형상 관리 |
여러 AWS 보안 서비스를 한꺼번에 켜면 가시성은 높아지지만 로그 저장·분석 비용이 크게 늘고 기존 보안 솔루션과 기능이 겹칠 수 있습니다. Baseline 적용 전에 기존 SIEM·EDR·방화벽과 역할을 나누고, HPC Compute 영역의 로그 수집 범위를 비용 관점에서 별도로 정의하는 것을 권고합니다.
8. 대규모 환경 구축 프로젝트에서 주의해야 할 점
■ 8.1 Ansible을 통한 '일관성 있는 자원 배포' 구조 만들기
수십 개의 Site와 수천 대의 노드를 수작업으로 하나씩 설정하면 일관성을 유지하기 어렵습니다. Terraform/CDK로 인프라를, EC2 Image Builder로 Golden AMI를, Ansible로 OS와 미들웨어 설정을 담당하게 해서 역할을 나누는 것이 효과적입니다.
| 설계 원칙 | 내용 |
|---|---|
| IaC & 자동화 | 자주 바뀌지 않는 요소(Driver, CUDA, EFA, Lustre Client, CIS 설정)는 AMI(On-Premise는 Golden Image)에 포함하고, Site별로 달라지는 요소(IdM 등록, Slurm 설정, Mount 정보)는 Ansible로 처리 |
| Role 단위 모듈화 | idm_client, slurm_node, lustre_client, nvidia_dcgm, monitoring_agent, cis_hardening 등 기능별 Role로 나누고, Site 간 차이는 group_vars로 표현 |
| 동적 Inventory | amazon.aws.aws_ec2 Inventory Plugin(Cloud)과 CMDB·BCM 연동 Inventory(On-Premise), 태그(Site, Cluster, Role)로 노드 자동 분류 → Auto Scaling 노드도 누락 없이 관리 |
| 대규모 실행 최적화 | forks 상향, strategy: free, Pipelining·Fact Caching 활성화, serial로 Rolling 적용해 전체 클러스터 동시 중단 방지 |
| 일관성과 검증 | 모든 Task는 재실행해도 결과가 같게 작성하고, Molecule 테스트와 NCCL/OSU Benchmark Smoke Test로 배포 후 자동 검증 |
| 실행 통제 | AWX/Ansible Automation Platform에서 승인 Workflow, 실행 이력, Credential을 중앙 관리(Secrets Manager 연동) |
■ 8.2 Control Plane 자원의 배치 최적화
| 구성 요소 | 권장 위치 | 이유 |
|---|---|---|
| Slurm Controller / slurmdbd (LSF Master) | On-Premise Site와 가장 가까운 AWS Region의 Multi-AZ EC2, 대륙별 Site는 인접 Region에 별도 구성 | DX 경유 수 ms 이내 제어 지연 유지, Region 장애·WAN 장애 시 피해 범위 제한 |
| IdM Replica | AWS Region Multi-AZ에 Primary 2대 + 각 Site에 IdM Replica(필요시 On-Premise) + Hidden replica(Backup) | 인증 조회의 로컬 응답, DX 단절 시에도 Site 로그인·Job 실행 유지 |
| Login Node / Portal | Control Plane과 같은 AWS Region(사용자는 SSO로 접속) | 사용자 위치와 무관한 단일 진입점, 대용량 데이터 조작은 Site 병렬 FS에서 수행 |
| License 서버 (FlexLM 등) | AWS Multi-AZ에 3-Server Redundancy, 대륙 간 Site는 지역 License 서버 추가 | 모든 실행 위치(On-Premise·Burst)에서 안정적 Check-out, Heartbeat 단절 방지 |
| 병렬 파일 시스템 | On-Premise Site(Lustre·GPFS·WEKA·VAST), Burst용은 FSx for Lustre | 연산 노드와 같은 Fabric에 두어 I/O 병목 방지 |
| Container Registry / Package Mirror | Region별 Cache(ECR Replication, Pull-through) | 수천 노드 동시 Pull 때 병목·비용 방지 |
| 모니터링·로그 수집 | Region별 수집 → 중앙 집계(Security 계정) | 대량 Metric을 원거리로 직접 전송하지 않음 |
| IaC·Ansible 실행 환경 | Shared Services 계정 + Site별 Execution Node | 원거리 SSH 대량 실행에 따른 지연·실패 방지 |
| Control Plane 전용 인스턴스 Sizing | 노드 규모 기준 산정(예: 수천 노드 → slurmctld 고메모리·고IOPS) | Control Plane 성능 부족이 전체 스케줄링 지연으로 이어짐 |
■ 8.3 그 밖에 반드시 챙겨야 할 체크리스트
| 영역 | 체크 항목 | 비고 |
|---|---|---|
| GPU Capacity 확보 | On-Demand 한도(Service Quota) 사전 증설, Capacity Blocks for ML·ODCR·Savings Plans 조합 | GPU 확보 실패는 일정 지연의 가장 흔한 원인 |
| 비용 가시성 | 태그 정책(Project·Site·CostCenter), Slurm Account ↔ AWS Cost Allocation Tag 매핑, 유휴 노드 자동 축소 | "모델별·프로젝트별 학습 비용" 리포트 체계 |
| 데이터 이관 | 초기 대용량 이관은 DataSync/Snowball, 이후 증분 동기화. 이관 검증(Checksum) | 이관 기간 동안 원천 데이터 Freeze 정책 |
| 관측성(Observability) | DCGM Exporter(GPU), Slurm Prometheus Metric, Amazon Managed Prometheus/Grafana | GPU 활용률·XID 에러·NCCL 성능을 운영 KPI로 |
| 성능 검증 | 구축 직후 HPL·NCCL Tests·OSU Micro-Benchmark등·IOR로 Baseline 측정 | 이후 장애 판단의 기준값 |
| 버전 정합성 | Driver·CUDA·NCCL·EFA·Slurm·OS 커널 버전 매트릭스 관리 | 서비스별 Known Issue와 Release Note 상시 확인 |
| 운영 조직·R&R | Global Follow-the-Sun 운영, Site별 유지보수 Window 조정, 장애 Escalation 체계 | 시간대가 다른 Site 간 변경 작업 충돌 방지 |
| 규제·데이터 주권 | 국가별 데이터 반출 규제, 수출통제(고성능 GPU·기술 데이터) 검토 | 법무·보안팀과 사전 협의 |
| DR 훈련 | Control Plane Failover, IdM Replica 손실, DX 단절 시나리오 정기 훈련 | 서비스의 영향을 고려한 DR 검증 |
▌요약
- HPC/AI 학습·추론 환경은 '구성의 속도와 안정성, 운영의 효율' 관점에서 설계해야 합니다. GPU·HPC 연산은 고정비 통제와 성능 관리에 유리한 On-Premise에, Control Plane·데이터·보안·운영은 Cloud에 두는 방식을 통해 효율적인 환경 구성 운영이 가능해지고 있습니다. 효율적인 Job 관리를 위한 스케줄러는 EDA·SLA 중심이면 LSF, AI GPU 팜과 AWS 관리형 연계는 Slurm이 유리하며, 어느 쪽이든 Fairshare·QoS·선점 정책으로 Project 간 공평성과 우선순위를 처음부터 설계해야 합니다.
- 성공의 열쇠는 자원의 수가 아니라 아키텍처, 특히 안정적인 Control Plane 설계입니다. Cloud의 Control Plane은 On-Premise Site와 가장 가까운 Region에 두고, 이중화된 전용선과 Site별로 분산된 인증 환경(IdM Replica 등)으로 WAN 장애에도 업무가 이어지게 설계해야 합니다. 사용자 ID는 IdM으로 통일하고, Site 수와 네트워크 지연을 고려한 Replica Topology로 Global 환경의 인증 안정성을 확보해야 합니다.
- 보안 Baseline과 자동화는 '나중에 고려하는 것'이 아니라 '처음부터 설계에 반영하는 것'입니다. NIST SP 800-53 기반의 7개 영역 Baseline(IAM, 네트워크, 로깅, 방화벽, 프로토콜, AMI, 패키지)을 착수 시점에 확정하고, EFA 통신·MPI SSH 같은 성능상 예외는 문서화해 관리해야 합니다. Terraform·Image Builder·Ansible로 구성한 반복 가능한 파이프라인이 있어야 새로운 Site와 GPU 세대에 빠르게 대응할 수 있습니다.
▌FAQ
Q1. On-Premise HPC/AI 학습·추론 환경과 AWS를 하나의 클러스터처럼 쓸 수 있나요?
A1. 사용자 ID, 데이터 계층, Job 제출 창구는 하나로 통합할 수 있습니다. 다만 On-Premise 노드와 AWS 노드를 하나의 MPI Job으로 묶는 것은 지연 차이 때문에 권장하지 않습니다. 용도와 Job의 특성을 고려하여 실행 위치를 나누는 정책의 적용이 성능 이슈를 방지할 수 있는 선택입니다.
Q2. LSF와 Slurm 중 하나로 통일해야 하나요?
A2. 반드시 그럴 필요는 없습니다. EDA·CAE처럼 상용 License와 SLA 정책이 중요한 영역은 LSF, AI 학습 GPU 팜은 Slurm으로 나눠 운영할 수 있습니다. 통합을 고려해야할 부분은 스케줄러가 아니라 사용자 ID(IdM), Project 코드, Fairshare와 같은 관리 정책의 기준 설정입니다.
Q3. Global 환경에서 계정관리를 위해 IdM 서버를 구성한다면 몇 대가 필요한가요?
A3. Site·Region마다 최소 2대를 권고합니다. IdM Master 간 동기화의 성능과 복잡도를 고려해 서버당 복제 Agreement는 4개 이하로 유지할 것을 권장합니다. 사용자 수보다는 Site 수와 네트워크 Latency(RTT)를 고려하여 Topology의 구성을 고려해야 합니다.
Q4. 보안 Baseline을 엄격하게 적용하면 Infra의 성능이 떨어지지 않나요?
A4. 대부분의 통제(암호화, 로깅, IMDSv2, Golden AMI)는 성능 영향이 거의 없습니다. 다만 EFA의 Self-referencing Security Group, MPI의 노드 간 통신, /tmp noexec 같은 일부 항목은 HPC 특성과 충돌할 수 있습니다. 이런 항목은 Compute 영역에 한정한 문서화된 예외로 관리하여 보안과 성능을 함께 관리하는 정책의 적용이 필요합니다.
▌참고자료
1. Hyperion Research / HPCwire, "Slicing and Dicing the HPC-AI Market with Hyperion Research," 2026.6.
2. HPCwire, "Slurm vs. Kubernetes in the Age of AI," 2026.5.
3. NVIDIA, "NVIDIA Acquires Open-Source Workload Management Provider SchedMD," 2025.12.
4. AWS, "AWS Parallel Computing Service now supports Slurm 25.11," 2026.4.
5. SchedMD, "Slurm Documentation – Multifactor Priority, Licenses Guide, Federated Scheduling."
6. IBM, "IBM Spectrum LSF Documentation."
7. Red Hat, "Thinking through Identity Management deployment."
8. NIST, "SP 800-53 Rev. 5: Security and Privacy Controls for Information Systems and Organizations."
※ 본문 이미지는 공개 자료를 바탕으로 구조를 단순화해 재구성한 개념도이며, 실제 구성은 제품과 규모에 따라 달라질 수 있습니다. 본문의 수치는 각 출처의 공개 자료를 기준으로 합니다.
관련 오퍼링 및 문의하기
본 콘텐츠는 저작권법에 의해 보호받는 저작물로 LG CNS에 저작권이 있습니다.
사전 동의 없이 2차 가공 및 영리적인 이용을 금합니다.